# Java基础面试题
大家好,我是小林。
Java 基础这块,在面试里的地位有点特殊——它不像 MySQL、Redis 那样每次都是核心考点,但如果你答得不好,会给面试官留下"基本功不扎实"的印象,这个代价其实挺大的。很多人用 Java 写了好几年代码,却说不清楚 JVM 和 JDK 的关系、int 和 Integer 的区别、为什么要重写 hashCode,这些问题看起来简单,但答起来很容易露馅。
这篇文章整理了 Java 基础面试中最常被问到的知识点,涵盖核心概念、数据类型、面向对象、关键字、反射、注解、异常、Java 8 新特性、IO 等内容,覆盖比较全面。内容偏向理解,不是让你背定义,而是帮你搞清楚"这个东西在 Java 里为什么是这样设计的"。
有几块在面试里出现频率特别高,建议重点花时间:
- 面向对象三大特性:封装、继承、多态,尤其是多态的几种体现形式、重载和重写的区别,这类题看起来基础,但很多人答得很浅,容易被追问到哑口无言。
- int 和 Integer:为什么要有包装类、自动装箱拆箱的原理、Integer 的缓存机制(-128 到 127),这条线问得很频繁,而且很容易出坑。
- String、StringBuffer、StringBuilder:三者的区别和适用场景,以及 String 不可变性的原理,这是一道老题,但每次还是会问。
- equals 和 hashCode:为什么要配套重写、不重写会有什么问题,在 HashMap 和 HashSet 里的影响,这个很多人只知道结论,答不出背后的原因。
- Java 8 新特性:Lambda 表达式、Stream API、Optional,这些在实际开发里用得很多,面试里也经常问。
- 反射机制:是什么、怎么用、实际应用在哪里(Spring 的 IOC 就是典型),这块理解清楚了对后面学框架原理很有帮助。
如果你是第一次系统准备 Java 基础,建议先把面向对象和数据类型搞清楚,再去看反射、注解这些稍微深一点的内容,整体理解起来会顺很多。
# 概念
# 说一下Java的特点
主要有以下的特点:
- 平台无关性:Java的“编写一次,运行无处不在”哲学是其最大的特点之一。Java编译器将源代码编译成字节码(bytecode),该字节码可以在任何安装了Java虚拟机(JVM)的系统上运行。
- 面向对象:Java是一门严格的面向对象编程语言,几乎一切都是对象。面向对象编程(OOP)特性使得代码更易于维护和重用,包括类(class)、对象(object)、继承(inheritance)、多态(polymorphism)、抽象(abstraction)和封装(encapsulation)。
- 内存管理:Java有自己的垃圾回收机制,自动管理内存和回收不再使用的对象。这样,开发者不需要手动管理内存,从而减少内存泄漏和其他内存相关的问题。
# Java 的优势和劣势是什么?
首先,Java的优势,我记得跨平台应该是一个大点,因为JVM的存在,一次编写到处运行。然后面向对象,这个可能也是优势,不过现在很多语言都支持面向对象,但是Java的设计从一开始就是OOP的。还有强大的生态系统,比如Spring框架,Hibernate,各种库和工具,社区支持大,企业应用广泛。另外,内存管理方面,自动垃圾回收机制,减少了内存泄漏的问题,对开发者友好。还有多线程支持,内置的线程机制,方便并发编程。安全性方面,Java有安全模型,比如沙箱机制,适合网络环境。还有稳定性,企业级应用长期使用,版本更新也比较注重向后兼容。
劣势的话,性能可能是一个,虽然JVM优化了很多,但相比C++或者Rust这种原生编译语言,还是有一定开销。特别是启动时间,比如微服务场景下,可能不如Go之类的快。语法繁琐,比如样板代码多,之前没有lambda的时候更麻烦,现在有了但比起Python还是不够简洁。内存消耗,JVM本身占内存,对于资源有限的环境可能不太友好。还有面向对象过于严格,有时候写简单程序反而麻烦,虽然Java8引入了函数式编程,但不如其他语言自然。还有开发效率,相比动态语言如Python,Java需要更多代码,编译过程也可能拖慢开发节奏。
# Java为什么是跨平台的?
Java 能支持跨平台,主要依赖于 JVM 关系比较大。
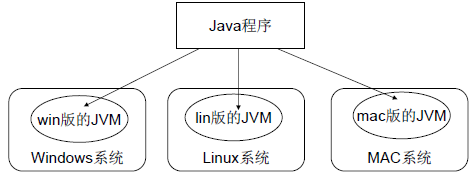
JVM也是一个软件,不同的平台有不同的版本。我们编写的Java源码,编译后会生成一种 .class 文件,称为字节码文件。Java虚拟机就是负责将字节码文件翻译成特定平台下的机器码然后运行。也就是说,只要在不同平台上安装对应的JVM,就可以运行字节码文件,运行我们编写的Java程序。
而这个过程中,我们编写的Java程序没有做任何改变,仅仅是通过JVM这一”中间层“,就能在不同平台上运行,真正实现了”一次编译,到处运行“的目的。
JVM是一个”桥梁“,是一个”中间件“,是实现跨平台的关键,Java代码首先被编译成字节码文件,再由JVM将字节码文件翻译成机器语言,从而达到运行Java程序的目的。
编译的结果不是生成机器码,而是生成字节码,字节码不能直接运行,必须通过JVM翻译成机器码才能运行。不同平台下编译生成的字节码是一样的,但是由JVM翻译成的机器码却不一样。
所以,运行Java程序必须有JVM的支持,因为编译的结果不是机器码,必须要经过JVM的再次翻译才能执行。即使你将Java程序打包成可执行文件(例如 .exe),仍然需要JVM的支持。
跨平台的是Java程序,不是JVM。JVM是用C/C++开发的,是编译后的机器码,不能跨平台,不同平台下需要安装不同版本的JVM。
# JVM、JDK、JRE三者关系?
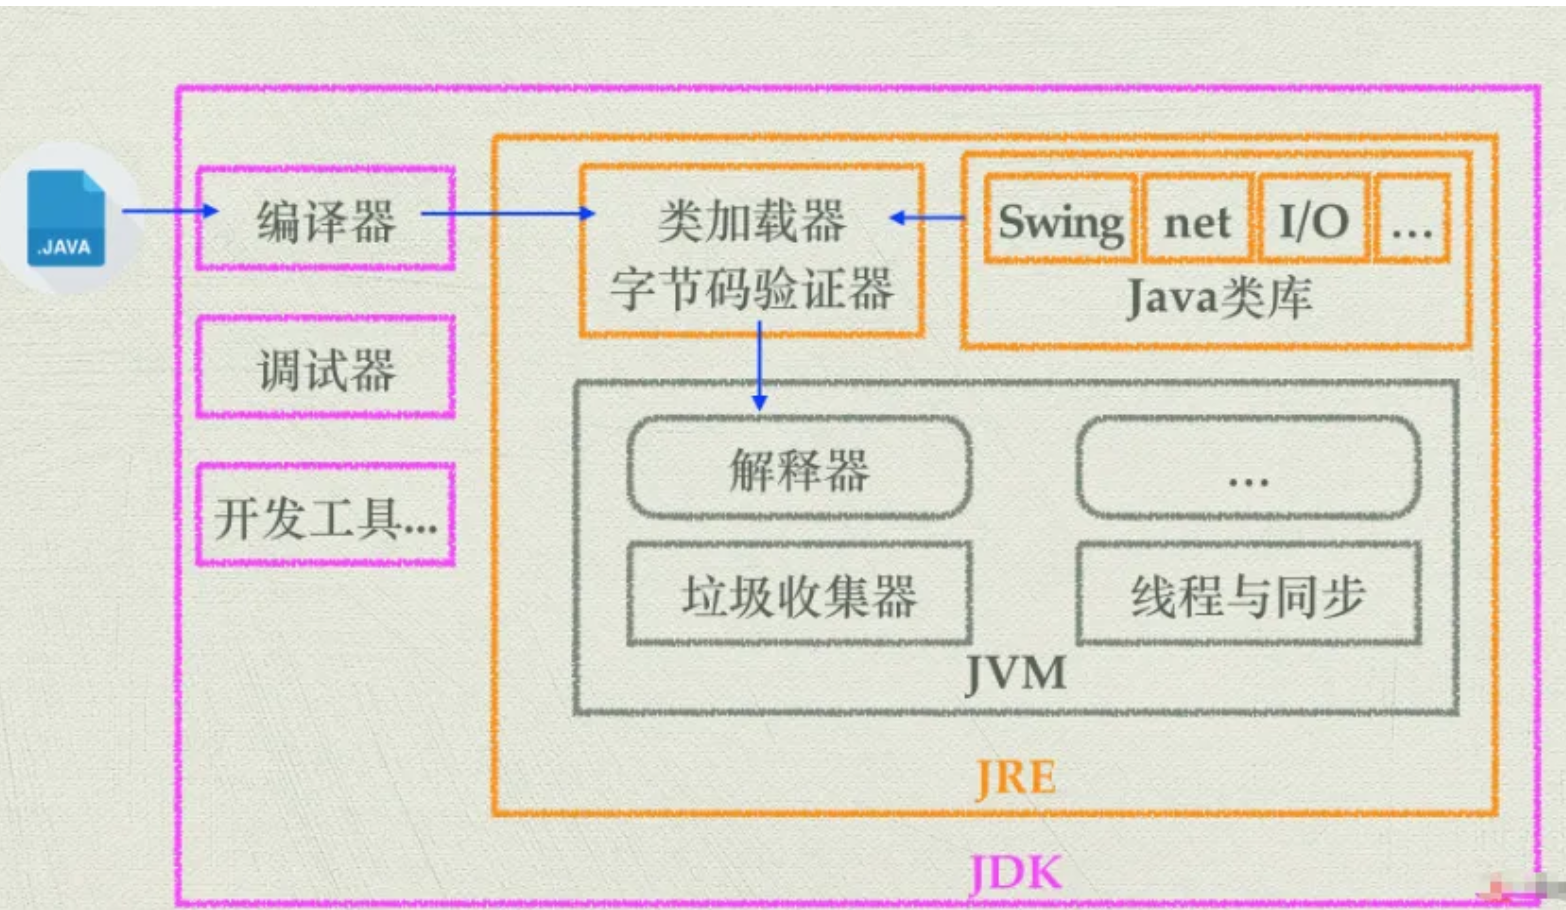
它们之间的关系如下:
- JVM是Java虚拟机,是Java程序运行的环境。它负责将Java字节码(由Java编译器生成)解释或编译成机器码,并执行程序。JVM提供了内存管理、垃圾回收、安全性等功能,使得Java程序具备跨平台性。
- JDK是Java开发工具包,是开发Java程序所需的工具集合。它包含了JVM、编译器(javac)、调试器(jdb)等开发工具,以及一系列的类库(如Java标准库和开发工具库)。JDK提供了开发、编译、调试和运行Java程序所需的全部工具和环境。
- JRE是Java运行时环境,是Java程序运行所需的最小环境。它包含了JVM和一组Java类库,用于支持Java程序的执行。JRE不包含开发工具,只提供Java程序运行所需的运行环境。
# JVM 和 Java 有啥区别?
Java是语言,JVM是平台,一个是写代码的工具,一个是跑代码的环境,两者分工不同但相互配合。
简单来说,Java是一门编程语言,就是我们平时写代码用的那个语言,像String、List这些都是Java语言提供的。而JVM呢,全称是Java虚拟机,它是用来运行Java程序的一个平台或者说运行环境。
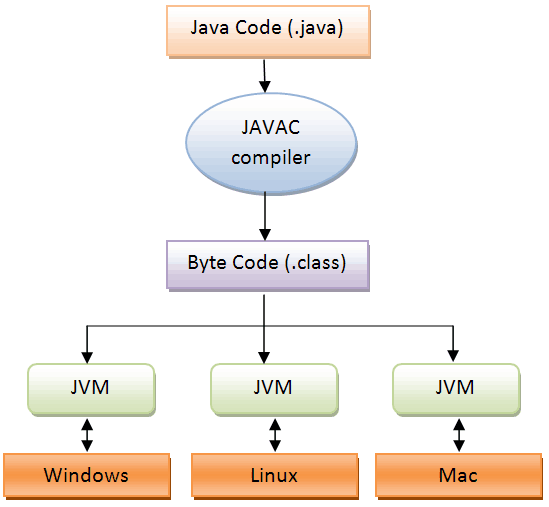
打个比方,Java就像是我们写文章用的中文,而JVM就像是能够阅读和理解这篇文章的人。我们用Java语言写代码,但代码不能直接运行,得先通过编译器编译成字节码,也就是.class文件,然后JVM再把这些字节码翻译成机器能懂的指令去执行。
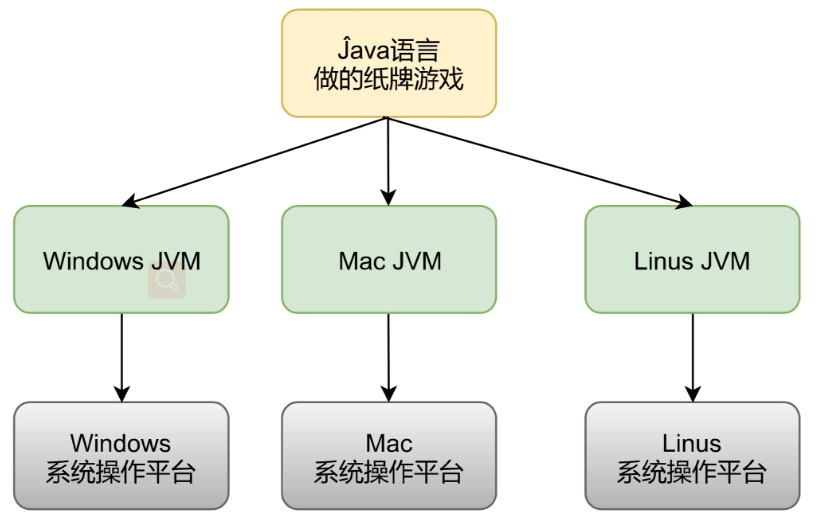
这里面还有一个很关键的点,就是Java能够跨平台,也就是"一次编译,到处运行"。这个跨平台能力其实主要是JVM提供的。我们写好的Java代码编译成字节码后,这份字节码可以在Windows的JVM上运行,也可以在Linux的JVM上运行,还可以在Mac上运行。虽然底层操作系统不一样,但因为有JVM这一层,它帮我们屏蔽了这些差异,做好了适配。所以本质上是JVM依赖平台,但Java字节码不依赖平台。
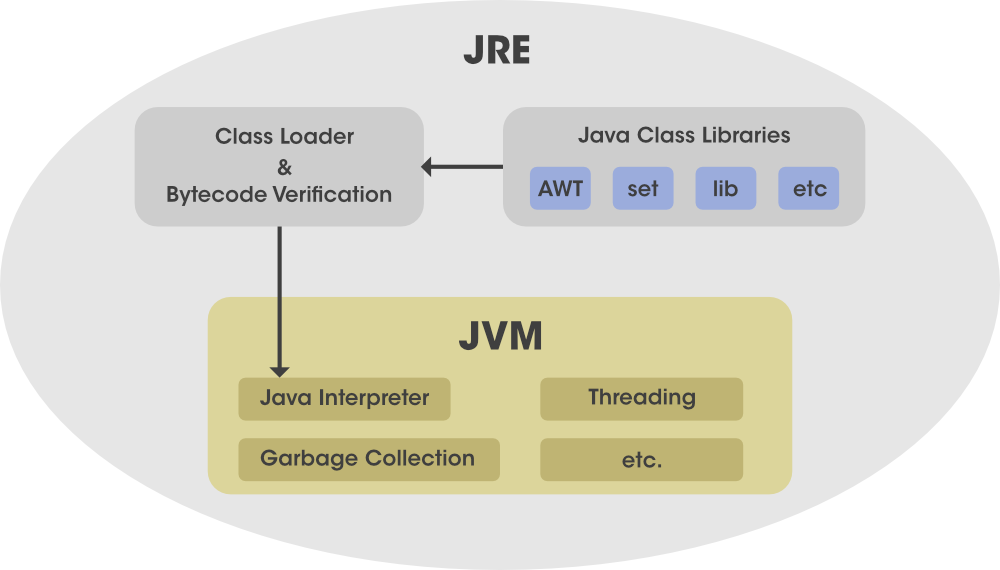
再简单说说它们和其他概念的关系。JDK是开发工具包,里面有编译器、调试工具这些,也包含了JRE。JRE是运行环境,包含了JVM和Java的核心类库。所以关系就是JDK大于JRE大于JVM,一个比一个小。如果你要开发Java程序就得装JDK,如果只是运行别人写好的程序,装个JRE就够了。
还有一点,JVM其实不只能跑Java。因为JVM执行的是字节码,所以像Kotlin、Scala这些语言,虽然语法跟Java不一样,但编译后也是生成Java字节码,一样可以在JVM上运行。所以JVM现在已经不只是Java的专属了,而是整个JVM语言生态的基础平台。
# 为什么Java解释和编译都有?
首先在Java经过编译之后生成字节码文件,接下来进入JVM中,就有两个步骤编译和解释。 如下图:
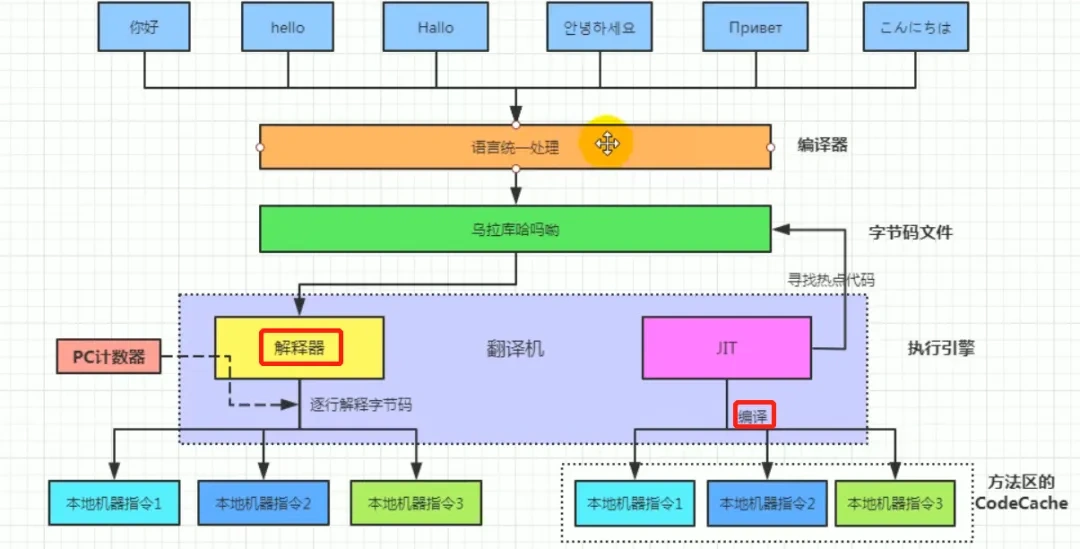
编译:
- Java 源代码会先被
javac编译为平台无关的字节码(.class)文件,这一步发生在程序运行之前。
解释 / JIT:
- JVM 启动后由解释器逐条解释执行字节码;同时 JVM 通过方法调用计数器和回边计数器识别热点代码,达到阈值后由 JIT 编译为本地机器码并缓存到 Code Cache 中,后续执行直接走机器码。
所以Java既是编译型也是解释性语言,默认采用的是解释器和编译器混合的模式。
# jvm是什么
JVM是 java 虚拟机,主要工作是解释自己的指令集(即字节码)并映射到本地的CPU指令集和OS的系统调用。
JVM屏蔽了与操作系统平台相关的信息,使得Java程序只需要生成在Java虚拟机上运行的目标代码(字节码),就可在多种平台上不加修改的运行,这也是Java能够“一次编译,到处运行的”原因。
# 编译型语言和解释型语言的区别?
编译型语言和解释型语言的区别在于:
- 编译型语言:在程序执行之前,整个源代码会被编译成目标平台的机器码(注:Java 这种"编译为字节码再由虚拟机解释 / JIT 执行"的模式严格说属于编译型与解释型的混合),生成可执行文件。执行时直接运行编译后的代码,速度快,但跨平台性较差。
- 解释型语言:在程序执行时,逐行解释执行源代码,不生成独立的可执行文件。通常由解释器动态解释并执行代码,跨平台性好,但执行速度相对较慢。
- 典型的编译型语言如C、C++,典型的解释型语言如Python、JavaScript。
# Python和Java区别是什么?
- Java 是一种编译与解释混合执行的语言:源代码先被
javac编译成字节码(.class),再由 JVM 加载后通过解释器 + JIT 即时编译器执行。 - Python 是一种解释型语言,运行时由解释器逐行翻译并执行源代码(CPython 内部也会先编译为字节码
.pyc,但整体执行模型仍以解释执行为主)。
# 值传递和引用传递的区别?
在 Java 中,参数传递只有值传递一种方式,不存在真正的 “引用传递”。但很多人会混淆这两个概念,核心区别在于传递的是 “值的副本” 还是 “引用的副本”。
值传递(Pass by Value)。传递的是实际值的副本,适用于基本数据类型(如 int、char 等),修改方法内的参数副本,不会影响原变量的值。例子:
public static void main(String[] args) {
    int num = 10;
    changeValue(num);
    System.out.println(num); // 输出 10(原变量未被修改)
}

public static void changeValue(int a) {
    a = 20; // 仅修改副本
}
引用传递的误解(本质仍是值传递)。对于对象(引用类型),传递的是对象引用的副本(而非对象本身)。
两个引用(原引用和副本)指向同一个对象,因此通过副本修改对象内部数据,会影响原对象。但如果修改副本的指向(如重新赋值),不会影响原引用的指向。示例:
public class Person {
    String name;
    Person(String name) { this.name = name; }
}

public static void main(String[] args) {
    Person p = new Person("Alice");
    changeName(p);
    System.out.println(p.name); // 输出 "Bob"(对象内部被修改)

    changeReference(p);
    System.out.println(p.name); // 仍输出 "Bob"(原引用指向未变)
}

// 修改对象内部数据
public static void changeName(Person obj) {
    obj.name = "Bob"; // 副本和原引用指向同一个对象
}

// 修改副本的指向(不影响原引用)
public static void changeReference(Person obj) {
    obj = new Person("Charlie"); // 副本指向新对象,原引用仍指向旧对象
}
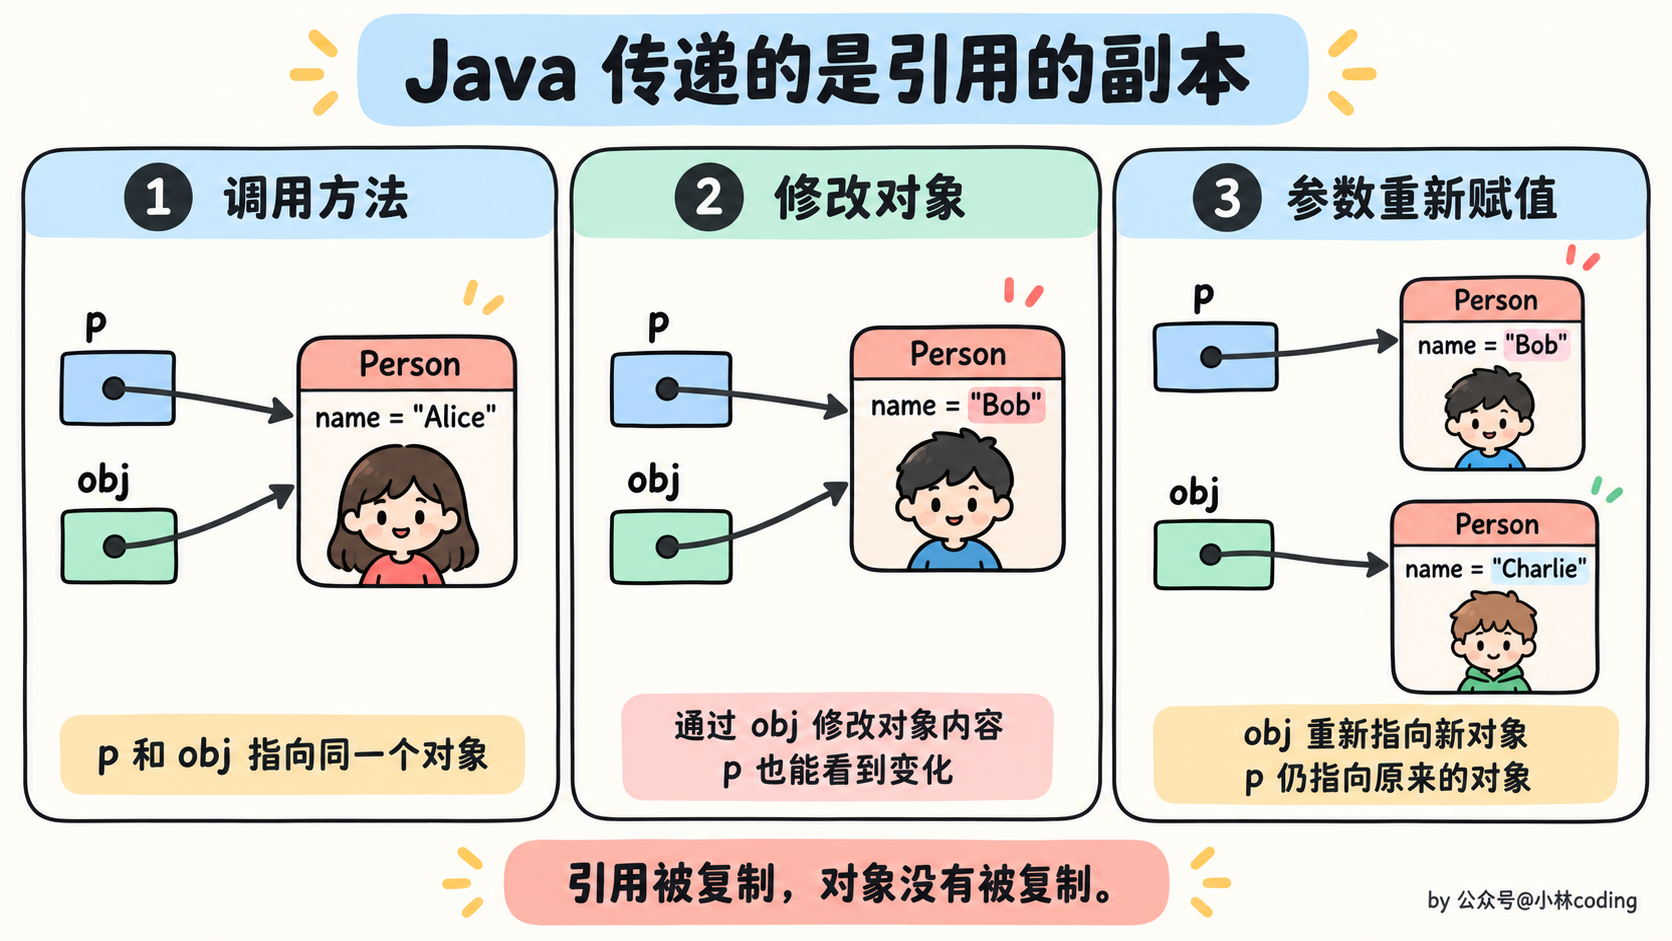
简单来说,Java 中所有参数传递都是值传递:
- 基本类型传递 “值的副本”,修改副本不影响原值。
- 引用类型传递 “引用的副本”,通过副本可修改对象内容,但无法改变原引用的指向。
# 数据类型
# 八种基本的数据类型
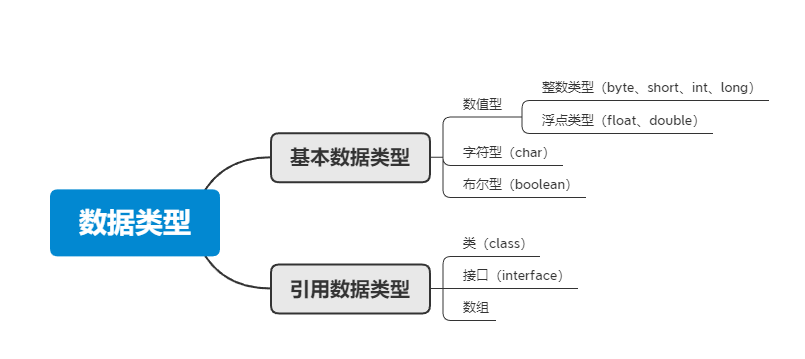
Java支持数据类型分为两类: 基本数据类型和引用数据类型。
基本数据类型共有8种,可以分为三类:
- 数值型:整数类型(byte、short、int、long)和浮点类型(float、double)
- 字符型:char
- 布尔型:boolean
8种基本数据类型的默认值、位数、取值范围,如下表所示:
| 数据类型 | 占用大小(字节) | 位数 | 取值范围 | 默认值 | 描述 |
|---|---|---|---|---|---|
byte | 1 | 8 | -128(-2^7) 到 127(2^7 - 1) | 0 | 是最小的整数类型,适合用于节省内存,例如在处理文件或网络流时存储小范围整数数据。 |
short | 2 | 16 | -32768(-2^15) 到 32767(2^15 - 1) | 0 | 较少使用,通常用于在需要节省内存且数值范围在该区间的场景。 |
int | 4 | 32 | -2147483648(-2^31) 到 2147483647(2^31 - 1) | 0 | 最常用的整数类型,可满足大多数日常编程中整数计算的需求。 |
long | 8 | 64 | -9223372036854775808(-2^63) 到 9223372036854775807(2^63 - 1) | 0L | 用于表示非常大的整数,当 int 类型无法满足需求时使用,定义时数值后需加 L 或 l。 |
float | 4 | 32 | -3.4028235E38 到 3.4028235E38 | 0.0f | 单精度浮点数,用于表示小数,精度相对较低,定义时数值后需加 F 或 f。 |
double | 8 | 64 | -1.7976931348623157E308 到 1.7976931348623157E308 | 0.0d | 双精度浮点数,精度比 float 高,是 Java 中表示小数的默认类型。 |
char | 2 | 16 | '\u0000'(0) 到 '\uffff'(65535) | '\u0000' | 用于表示单个字符,采用 Unicode 编码,可表示各种语言的字符。 |
boolean | 无明确字节大小(理论上 1 位) | 无明确位数 | true 或 false | false | 用于逻辑判断,只有两个取值,常用于条件判断和循环控制等逻辑场景。 |
Float 和 Double 的最大值都是以科学记数法的形式输出的,结尾的"E+数字"表示 E 之前的数字要乘以 10 的多少倍。比如 3.14E3 就是 3.14×1000=3140,3.14E-3 就是 3.14/1000=0.00314。注意:Float.MIN_VALUE / Double.MIN_VALUE 表示的是最小正非零值(如 1.4E-45),并不是负的最小值;浮点类型的最小负值是 -MAX_VALUE。
注意一下几点:
- Java八种基本数据类型的字节数:1字节(byte、boolean)、 2字节(short、char)、4字节(int、float)、8字节(long、double)
- 浮点数的默认类型为double(如果需要声明一个常量为float型,则必须要在末尾加上f或F)
- 整数的默认类型为int(声明Long型在末尾加上l或者L)
- 八种基本数据类型的包装类:除了char的是Character、int类型的是Integer,其他都是首字母大写
- char类型是无符号的,不能为负,所以是0开始的
# int和long是多少位,多少字节的?
int类型是 32 位(bit),占 4 个字节(byte),int 是有符号整数类型,其取值范围是从 -2^31 到 2^31-1 。例如,在一个简单的计数器程序中,如果使用int类型来存储计数值,它可以表示的最大正数是 2,147,483,647。如果计数值超过这个范围,就会发生溢出,导致结果不符合预期。long类型是 64 位,占 8 个字节,long类型也是有符号整数类型,它的取值范围是从 -2^63 到 2^63 -1 ,在处理较大的整数数值时,如果int类型的取值范围不够,就需要使用long类型。例如,在一个文件传输程序中,文件的大小可能会很大,使用int类型可能无法准确表示,而long类型就可以很好地处理这种情况。
# long和int可以互转吗 ?
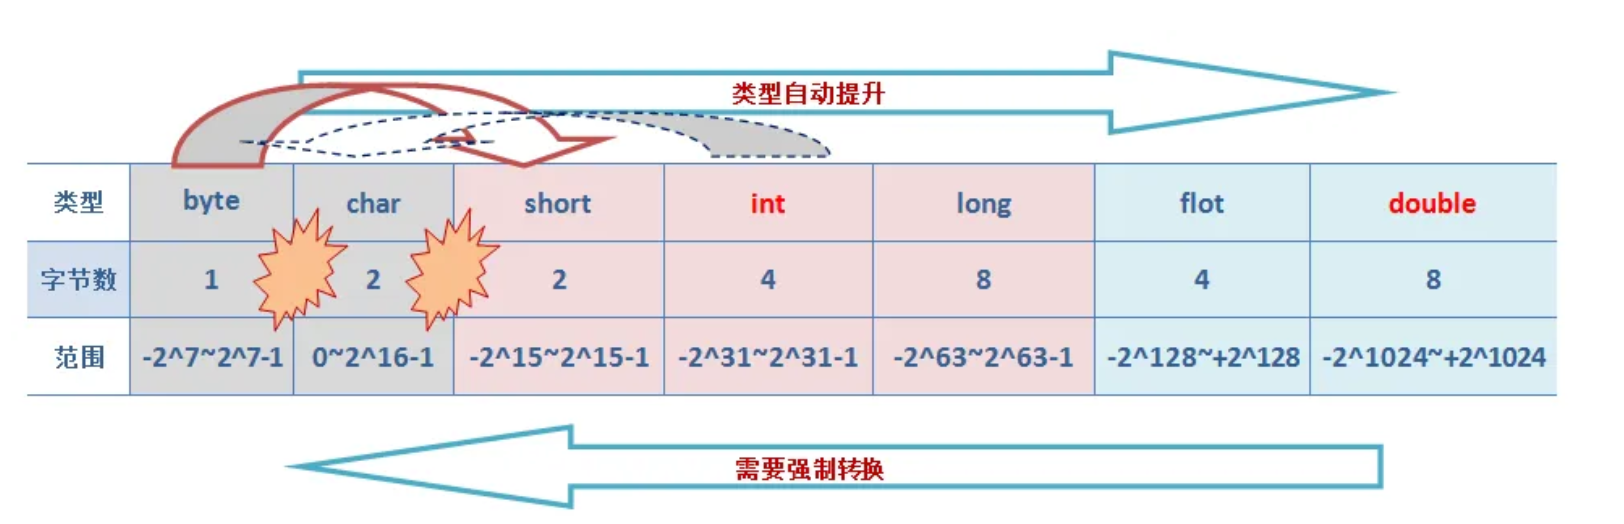
可以的,Java中的long和int可以相互转换。由于long类型的范围比int类型大,因此将int转换为long是安全的,而将long转换为int可能会导致数据丢失或溢出。
将int转换为long可以通过直接赋值或强制类型转换来实现。例如:
int intValue = 10;
long longValue = intValue; // 自动转换,安全的
将long转换为int需要使用强制类型转换,但需要注意潜在的数据丢失或溢出问题。
例如:
long longValue = 100L;
int intValue = (int) longValue; // 强制类型转换,可能会有数据丢失或溢出
在将long转换为int时,如果longValue的值超出了int类型的范围,转换结果将是截断后的低位部分。因此,在进行转换之前,建议先检查longValue的值是否在int类型的范围内,以避免数据丢失或溢出的问题。
# 数据类型转换方式你知道哪些?
- 自动类型转换(隐式转换):当目标类型的范围大于源类型时,Java会自动将源类型转换为目标类型,不需要显式的类型转换。例如,将
int转换为long、将float转换为double等。 - 强制类型转换(显式转换):当目标类型的范围小于源类型时,需要使用强制类型转换将源类型转换为目标类型。这可能导致数据丢失或溢出。例如,将
long转换为int、将double转换为int等。语法为:目标类型 变量名 = (目标类型) 源类型。 - 字符串转换:Java提供了将字符串表示的数据转换为其他类型数据的方法。例如,将字符串转换为整型
int,可以使用Integer.parseInt()方法;将字符串转换为浮点型double,可以使用Double.parseDouble()方法等。 - 数值之间的转换:Java提供了一些数值类型之间的转换方法,如将整型转换为字符型、将字符型转换为整型等。这些转换方式可以通过类型的包装类来实现,例如
Character类、Integer类等提供了相应的转换方法。
# 类型互转会出现什么问题吗?
基本数据类型转换的问题
当把小范围数据类型赋值给大范围数据类型时,Java 会自动进行类型转换,这种转换一般是安全的。
int num = 100;
long bigNum = num; // 自动将int转换为long
但是大范围数据类型赋值给小范围数据类型时,会发生数据数据溢出或者精度损失的问题。
- 数据溢出:如果大范围数据类型赋值给小范围数据类型时,当目标类型无法容纳原数据时,就会发生数据溢出。比如下面,byte 类型的取值范围是 - 128 到 127。300 的二进制表示为
00000001 00101100,强制转换为 byte 类型时,会丢弃高位字节,只保留低位的 8 位00101100,其十进制值为 44。
int largeNum = 300;
byte b = (byte) largeNum; // b的值为44
- 精度损失:在进行浮点数类型的转换时,可能会发生精度损失。由于浮点数的表示方式不同,将一个单精度浮点数(
float)转换为双精度浮点数(double)时,精度可能会损失,如果 double 转换为 int 也会发生精度损失的问题,如下:
double d = 3.14;
int i = (int) d; // i的值为3,小数部分0.14被舍弃
对象引用转换的问题
向上转型是自动进行的,而且是安全的,如下:
class Animal {}
class Dog extends Animal {}

Dog dog = new Dog();
Animal animal = dog; // 自动向上转型
但是向下转型需要手动进行,并且存在风险。如果父类对象实际上并不是目标子类的实例,在转型时就会抛出异常:
Animal animal = new Animal();
Dog dog = (Dog) animal; // 运行时抛出ClassCastException
原因是Java 的对象在运行时会记录其真实类型,当进行向下转型时,Java 会检查对象的实际类型是否与目标类型兼容。如果不兼容,就会抛出ClassCastException。
解决方式是需要使用 instanceof 检查:
if (animal instanceof Dog) {
    Dog dog = (Dog) animal; // 只有确认animal是Dog的实例时才进行转型
}
# 为什么用bigDecimal 不用double ?
对于金额这类要求十进制计算准确的场景,一般使用BigDecimal,因为double不能精确表示很多十进制小数。
double使用二进制浮点数表示数值。就像十进制无法用有限位数准确表示1/3一样,二进制也无法用有限位数准确表示0.1、0.2这些数,只能保存它们的近似值,计算时就可能出现误差。
System.out.println(0.1 + 0.2); // 0.30000000000000004

BigDecimal a = new BigDecimal("0.1");
BigDecimal b = new BigDecimal("0.2");
System.out.println(a.add(b)); // 0.3
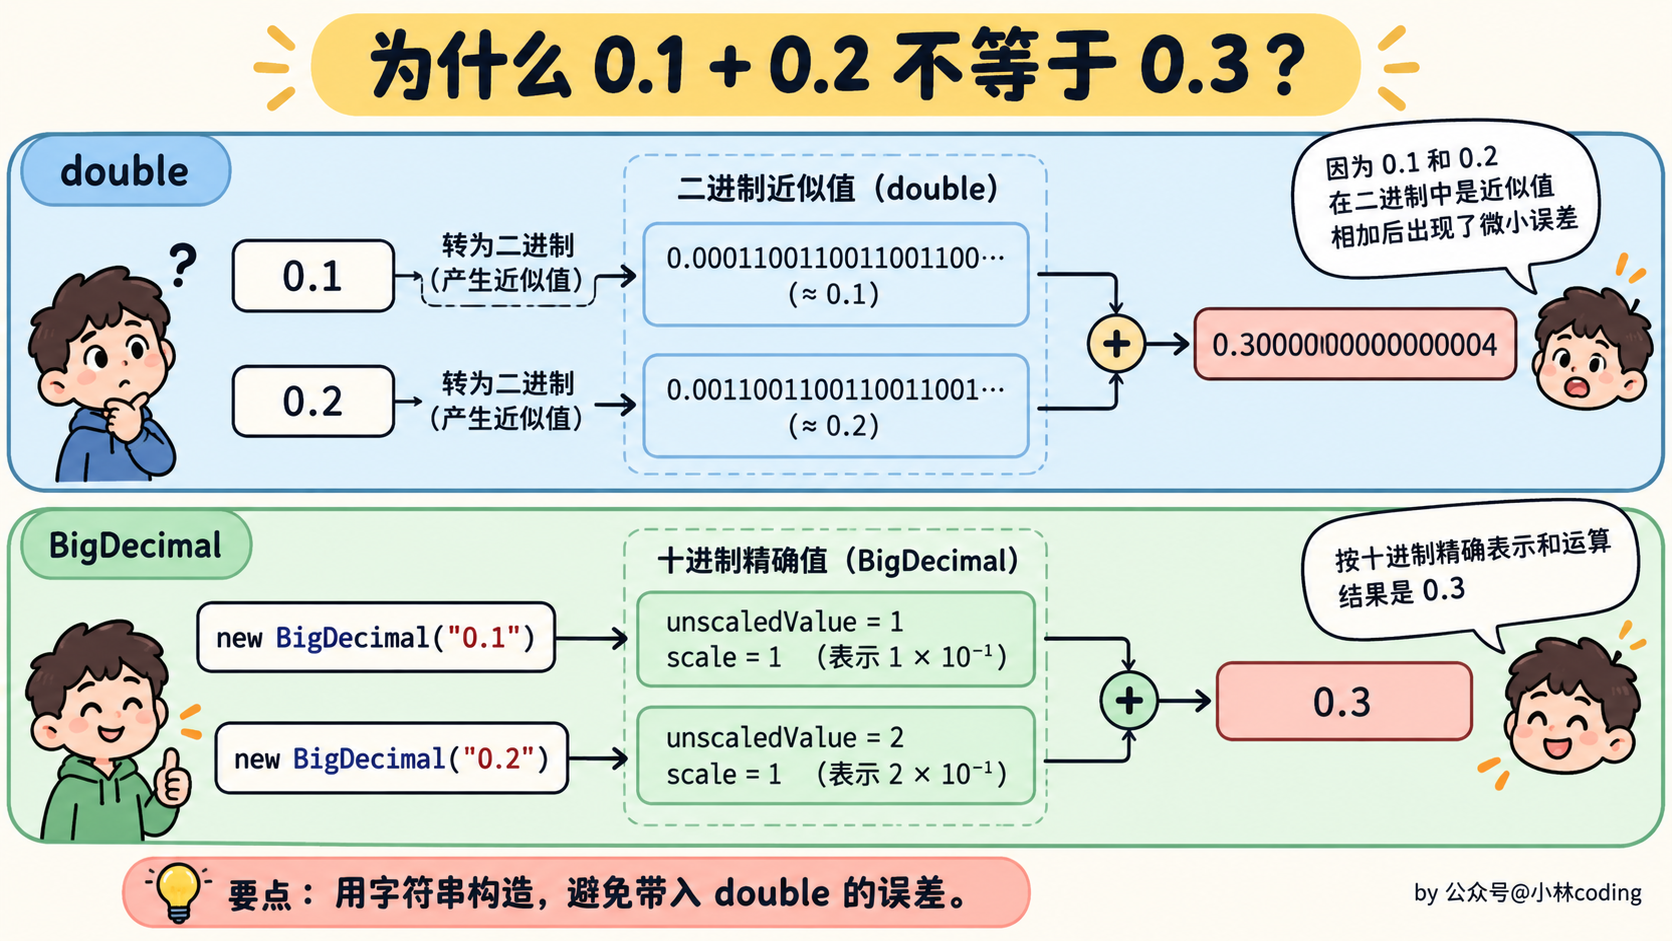
BigDecimal可以理解为用一个任意精度整数和一个scale来表示十进制数,比如1.23可以表示为123乘以10的-2次方。这样可以准确保存十进制数值,并按指定规则进行运算。
不过,用BigDecimal也有几个需要注意的地方:
创建对象时避免直接传double
new BigDecimal(0.1)会把double已经存在的近似值转换成BigDecimal,不能得到我们想要的精确十进制0.1。一般使用字符串构造;如果数据本来就是double,可以使用BigDecimal.valueOf,它会通过double的字符串表示来构造。
BigDecimal price = new BigDecimal("0.1");
BigDecimal value = BigDecimal.valueOf(0.1);
但valueOf不能修复之前浮点运算产生的误差,比如先算0.1 + 0.2再传进去,得到的仍然是0.30000000000000004。所以金额最好从输入和存储环节就使用明确的十进制表示。
除法需要考虑舍入规则
BigDecimal并不代表所有计算都能得到有限位数的精确结果。比如1除以3,如果要求精确结果,又没有指定舍入规则,就会抛出ArithmeticException。
BigDecimal result = BigDecimal.ONE.divide(
    new BigDecimal("3"), 2, RoundingMode.HALF_UP
);
System.out.println(result); // 0.33,保留两位小数,按HALF_UP舍入
保留几位小数、采用哪种舍入规则,需要根据业务约定,不能随便设置。
比较数值时区分equals和compareTo
equals会同时比较数值和scale,而compareTo只比较数值大小:
BigDecimal x = new BigDecimal("1.0");
BigDecimal y = new BigDecimal("1.00");

System.out.println(x.equals(y));       // false,scale不同
System.out.println(x.compareTo(y));   // 0,数值相等
所以,如果只是判断金额数值是否相等,一般使用compareTo(...) == 0。另外,BigDecimal是不可变对象,add、subtract等方法返回的是计算结果,需要接住返回值。
double也不是不能用,它适合允许一定误差的浮点计算。是否使用BigDecimal,主要看业务对精度和舍入的要求。
# 装箱和拆箱是什么?
装箱(Boxing)和拆箱(Unboxing)是将基本数据类型和对应的包装类之间进行转换的过程。
Integer i = 10;  //装箱
int n = i;   //拆箱
自动装箱主要发生在两种情况,一种是赋值时,另一种是在方法调用的时候。
赋值时
这是最常见的一种情况,在Java 1.5以前我们需要手动地进行转换才行,而现在所有的转换都是由编译器来完成。
//before autoboxing
Integer iObject = Integer.valueOf(3);
int iPrimitive = iObject.intValue();

//after java5
Integer iObject = 3; //autoboxing - primitive to wrapper conversion
int iPrimitive = iObject; //unboxing - object to primitive conversion
方法调用时
当我们在方法调用时,我们可以传入原始数据值或者对象,同样编译器会帮我们进行转换。
public static Integer show(Integer iParam){
   System.out.println("autoboxing example - method invocation i: " + iParam);
   return iParam;
}

//autoboxing and unboxing in method invocation
show(3); //autoboxing
int result = show(3); //unboxing because return type of method is Integer
show方法接受Integer对象作为参数,当调用show(3)时,会将int值转换成对应的Integer对象,这就是所谓的自动装箱,show方法返回Integer对象,而int result = show(3);中result为int类型,所以这时候发生自动拆箱操作,将show方法的返回的Integer对象转换成int值。
自动装箱的弊端
自动装箱有一个问题,那就是在一个循环中进行自动装箱操作的情况,如下面的例子就会创建多余的对象,影响程序的性能。
Integer sum = 0; for(int i=1000; i<5000; i++){ sum+=i; }
上面的代码sum+=i可以看成sum = sum + i,但是+这个操作符不适用于Integer对象,首先sum进行自动拆箱操作,进行数值相加操作,最后发生自动装箱操作转换成Integer对象。其内部变化如下
int result = sum.intValue() + i; Integer sum = Integer.valueOf(result);
由于我们这里声明的 sum 为 Integer 类型,自动装箱实际上由编译器替换为 Integer.valueOf(...) 调用,命中 IntegerCache(默认 -128~127)时会复用缓存对象,但本例中循环值都已超出缓存范围,因此会创建将近 4000 个 Integer 对象,降低程序性能并加重 GC 负担。因此在编程时需要注意:正确声明变量类型,避免因为自动装箱引起的性能问题(另外,new Integer(int) 自 JDK 9 起已被 @Deprecated,应统一使用 Integer.valueOf(int) 或直接自动装箱)。
# Java为什么要有Integer?
Integer是int类型的包装类,就是把一个int值包装成对象。它最主要的作用,是让整数也能用在需要对象的地方。
泛型和集合中的应用
Java中的泛型类型参数不能直接使用基本数据类型,比如不能写List<int>,但可以写List<Integer>。所以,当我们想把整数放进ArrayList、HashMap这些集合里时,就需要用到Integer。
List<Integer> list = new ArrayList<>();
list.add(10); // 自动装箱,相当于Integer.valueOf(10)

int num = list.get(0); // 自动拆箱,相当于调用intValue()
这里虽然写的是list.add(10),看起来直接把int放进了集合,但编译器实际上会帮我们完成装箱,集合中保存的仍然是Integer对象。
表示没有值的情况
Integer还有一个作用,就是可以用null表示“没有值”,而int不能。
比如一个用户的年龄还没有填写,如果用int存储,单靠一个0,就很难区分“没有填写”和“年龄就是0”;如果用Integer,就可以用null表示没有填写。
不过,Integer为null时不能自动拆箱,否则会抛出NullPointerException。
Integer age = null;
int num = age; // 自动拆箱时抛出NullPointerException
提供处理整数的方法
Integer还提供了很多处理整数的工具方法,比如字符串转整数、整数转字符串、进制转换等。
int num = Integer.parseInt("123");       // 字符串转int
String str = Integer.toString(123);      // int转字符串
String hex = Integer.toHexString(255);   // 转十六进制,结果为"ff"
注意,这些是静态方法,调用它们不需要先创建Integer对象。比如int转String,直接用Integer.toString(123)或者String.valueOf(123)就可以了。
所以,Integer主要是为了适配集合、泛型这些需要引用类型的场景,以及表达空值。如果只是普通的数值计算、循环计数,一般优先使用int,避免不必要的装箱和拆箱。
# Integer相比int有什么优点?
int是Java中的原始数据类型,而Integer是int的包装类。
Integer和 int 的区别:
- 基本类型和引用类型:首先,int是一种基本数据类型,而Integer是一种引用类型。基本数据类型是Java中最基本的数据类型,它们是预定义的,不需要实例化就可以使用。而引用类型则需要通过实例化对象来使用。这意味着,使用int来存储一个整数时,不需要任何额外的内存分配,而使用Integer时,必须为对象分配内存。在性能方面,基本数据类型的操作通常比相应的引用类型快。
- 自动装箱和拆箱:其次,Integer作为int的包装类,它可以实现自动装箱和拆箱。自动装箱是指将基本类型转化为相应的包装类类型,而自动拆箱则是将包装类类型转化为相应的基本类型。这使得Java程序员更加方便地进行数据类型转换。例如,当我们需要将int类型的值赋给Integer变量时,Java可以自动地将int类型转换为Integer类型。同样地,当我们需要将Integer类型的值赋给int变量时,Java可以自动地将Integer类型转换为int类型。
- 空指针异常:另外,int 变量默认值为 0,而 Integer 作为引用类型默认值为 null。如果对一个值为 null 的 Integer(如未显式赋值的成员变量)执行自动拆箱操作,就会抛出空指针异常,因为 null 无法被拆箱为基本类型。
# 那为什么还要保留int类型?
包装类是引用类型,对象的引用和对象本身是分开存储的,而对于基本类型数据,变量对应的内存块直接存储数据本身。
因此,基本类型数据在读写效率方面,要比包装类高效。除此之外,在64位JVM上,在开启引用压缩的情况下,一个Integer对象占用16个字节的内存空间,而一个int类型数据只占用4字节的内存空间,前者对空间的占用是后者的4倍。
也就是说,不管是读写效率,还是存储效率,基本类型都比包装类高效。
# 说一下 integer的缓存
Integer内部有一个IntegerCache,用来缓存一部分常用整数对应的Integer对象。当我们通过Integer.valueOf创建这些数值的对象时,会直接复用缓存,而不是每次都创建新对象。
Integer.valueOf至少会缓存-128到127。HotSpot默认的缓存范围也是-128到127,缓存上限可以通过JVM参数调整,所以不能把所有超出这个范围的值都当成一定不缓存。
自动装箱会调用Integer.valueOf,所以也会用到缓存:
Integer a = 127;
Integer b = 127;
System.out.println(a == b); // true,复用了同一个缓存对象

Integer c = 128;
Integer d = 128;
System.out.println(c == d); // 默认缓存范围下为false
System.out.println(c.equals(d)); // true,比较的是整数值
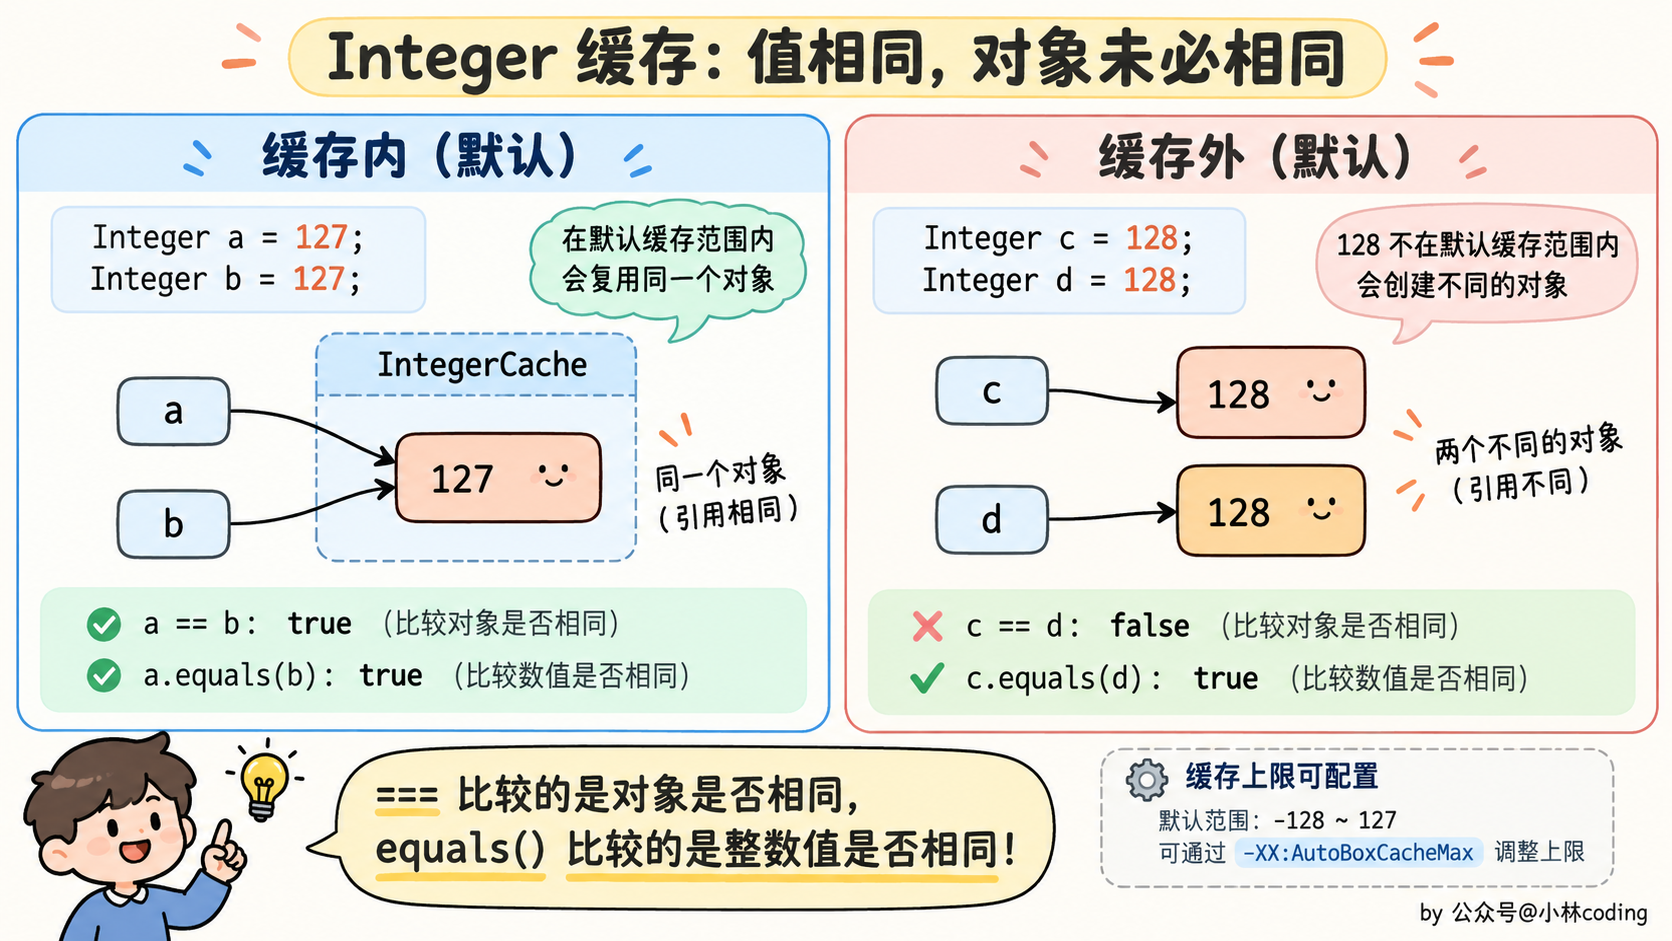
这里的关键是,两个Integer用==比较时,比较的是不是同一个对象,而不是数值是否相等。缓存只是让一部分相同数值恰好指向了同一个对象,不能因此认为Integer可以统一用==比较数值。
如果显式使用new Integer(...),则会创建新对象,不会复用IntegerCache。这个构造方法从Java 9开始已经被标记为过时,正常使用Integer.valueOf或者自动装箱即可。
还有一个容易混淆的情况,就是Integer和int比较:
Integer num = 128;
System.out.println(num == 128); // true,num先拆箱,再比较int值
不过,如果num是null,这个比较就会在自动拆箱时抛出NullPointerException。实际开发中,比较两个Integer的数值一般使用equals,需要兼容null时可以使用Objects.equals。
Integer缓存的目的主要是减少常用小整数的重复对象分配,节省内存,不能把它当作业务代码判断数值相等的依据。
# 面向对象
# 怎么理解面向对象?简单说说封装继承多态
面向对象是一种编程范式,它将现实世界中的事物抽象为对象,对象具有属性(称为字段或属性)和行为(称为方法)。面向对象编程的设计思想是以对象为中心,通过对象之间的交互来完成程序的功能,具有灵活性和可扩展性,通过封装和继承可以更好地应对需求变化。
Java面向对象的三大特性包括:封装、继承、多态:
- 封装:封装是指将对象的属性(数据)和行为(方法)结合在一起,对外隐藏对象的内部细节,仅通过对象提供的接口与外界交互。封装的目的是增强安全性和简化编程,使得对象更加独立。
- 继承:继承是一种可以使得子类自动共享父类数据结构和方法的机制。它是代码复用的重要手段,通过继承可以建立类与类之间的层次关系,使得结构更加清晰。
- 多态:多态是指允许不同类的对象对同一消息作出响应。即同一个接口,使用不同的实例而执行不同操作。多态性可以分为编译时多态(重载)和运行时多态(重写)。它使得程序具有良好的灵活性和扩展性。
# 多态体现在哪几个方面?
多态在面向对象编程中可以体现在以下几个方面:
- 方法重载:
- 方法重载是指同一类中可以有多个同名方法,它们具有不同的参数列表(参数类型、数量或顺序不同)。虽然方法名相同,但根据传入的参数不同,编译器会在编译时确定调用哪个方法。
- 示例:对于一个
add方法,可以定义为add(int a, int b)和add(double a, double b)。
- 方法重写:
- 方法重写是指子类能够提供对父类中同名方法的具体实现。在运行时,JVM会根据对象的实际类型确定调用哪个版本的方法。这是实现多态的主要方式。
- 示例:在一个动物类中,定义一个
sound方法,子类Dog可以重写该方法以实现bark,而Cat可以实现meow。
- 接口与实现:
- 多态也体现在接口的使用上,多个类可以实现同一个接口,并且用接口类型的引用来调用这些类的方法。这使得程序在面对不同具体实现时保持一贯的调用方式。
- 示例:多个类(如
Dog,Cat)都实现了一个Animal接口,当用Animal类型的引用来调用makeSound方法时,会触发对应的实现。
- 向上转型和向下转型:
- 在Java中,可以使用父类类型的引用指向子类对象,这是向上转型。通过这种方式,可以在运行时期采用不同的子类实现。
- 向下转型是将父类引用转回其子类类型,但在执行前需要确认引用实际指向的对象类型以避免
ClassCastException。
# 多态解决了什么问题?
多态是指子类可以替换父类,在实际的代码运行过程中,调用子类的方法实现。多态这种特性也需要编程语言提供特殊的语法机制来实现,比如继承、接口类。
多态可以提高代码的扩展性和复用性,是很多设计模式、设计原则、编程技巧的代码实现基础。比如策略模式、基于接口而非实现编程、依赖倒置原则、里式替换原则、利用多态去掉冗长的 if-else 语句等等
# 面向对象的设计原则你知道有哪些吗
面向对象编程中的六大原则:
- 单一职责原则(SRP):一个类应该只有一个引起它变化的原因,即一个类应该只负责一项职责。例子:考虑一个员工类,它应该只负责管理员工信息,而不应负责其他无关工作。
- 开放封闭原则(OCP):软件实体应该对扩展开放,对修改封闭。例子:通过制定接口来实现这一原则,比如定义一个图形类,然后让不同类型的图形继承这个类,而不需要修改图形类本身。
- 里氏替换原则(LSP):子类对象应该能够替换掉所有父类对象。例子:一个正方形是一个矩形,但如果修改一个矩形的高度和宽度时,正方形的行为应该如何改变就是一个违反里氏替换原则的例子。
- 接口隔离原则(ISP):客户端不应该依赖那些它不需要的接口,即接口应该小而专。例子:通过接口抽象层来实现底层和高层模块之间的解耦,比如使用依赖注入。
- 依赖倒置原则(DIP):高层模块不应该依赖低层模块,二者都应该依赖于抽象;抽象不应该依赖于细节,细节应该依赖于抽象。例子:如果一个公司类包含部门类,应该考虑使用合成/聚合关系,而不是将公司类继承自部门类。
- 最少知识原则 (Law of Demeter):一个对象应当对其他对象有最少的了解,只与其直接的朋友交互。
# 重载与重写有什么区别?
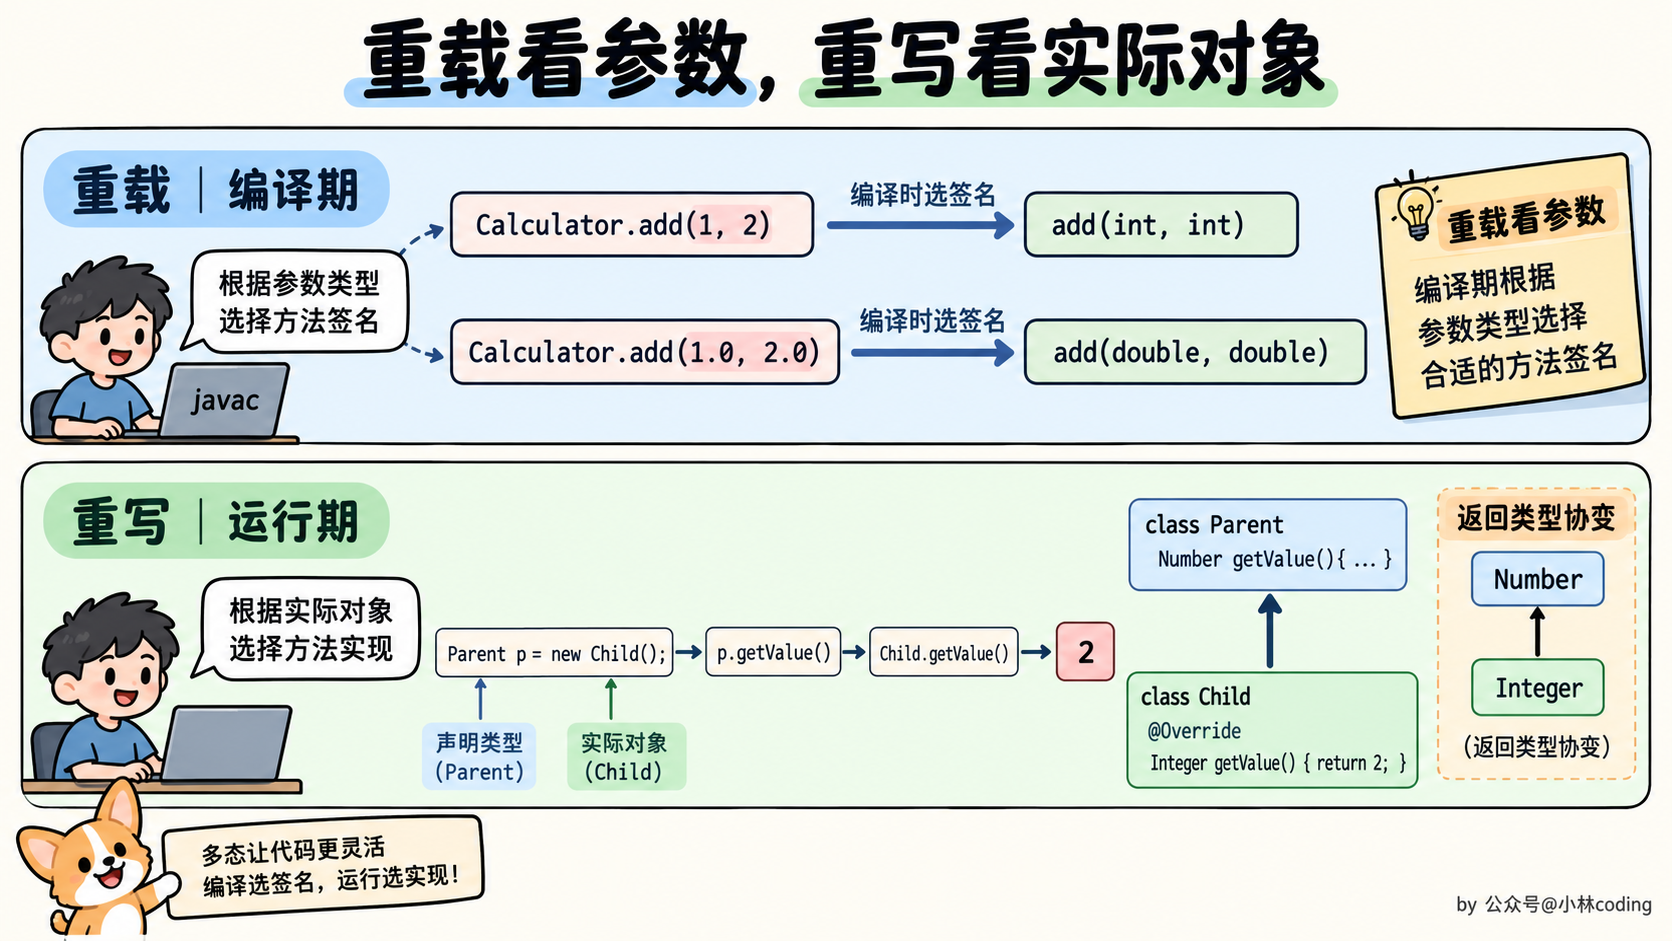
**重载是同名方法的参数列表不同,重写是子类重新实现父类的方法。**它们最大的区别,是方法选择发生的时机不同。
重载(Overloading)
重载可以发生在同一个类中,也可以涉及继承得到的方法。方法名相同,但参数的类型、数量或者类型顺序不同,编译器会根据调用时的参数和声明类型,选择对应的方法。
class Calculator {
    public int add(int a, int b) {
        return a + b;
    }

    public double add(double a, double b) {
        return a + b;
    }
}
比如add(1, 2)匹配int参数的方法,add(1.0, 2.0)匹配double参数的方法。
注意,不能只靠返回类型不同来重载方法。如果方法名和参数列表相同,只修改返回类型,编译器会认为方法重复。
重写(Overriding)
重写发生在继承关系中。子类对父类可被重写的实例方法提供新的实现,方法名和参数列表保持一致。调用时,JVM会根据对象的实际类型执行对应的实现。
class Parent {
    public Number getValue() {
        return 1;
    }
}

class Child extends Parent {
    @Override
    public Integer getValue() {
        return 2;
    }
}
这里子类返回Integer,父类返回Number,也是合法的重写,因为Integer是Number的子类,这叫协变返回类型。
Parent obj = new Child();
System.out.println(obj.getValue()); // 输出2,执行的是Child的方法
重写还有几个限制:
- 返回类型如果是基本类型或者void,要与父类一致;如果是引用类型,可以与父类相同,也可以是父类返回类型的子类型。
- 访问权限不能比父类更严格,比如父类是public,子类不能改成protected。
- 不能新增父类方法没有声明的受检异常,也不能把受检异常的范围扩大,但可以不抛或者抛更具体的受检异常。
- final方法不能重写,private方法不被子类继承;static方法属于类,子类的同名同参数静态方法属于隐藏,不是重写。
@Override不是重写成立的必要条件,但建议加上,让编译器帮我们检查方法是否真的重写成功,避免把参数写错后变成了重载。
所以,重载主要是在编译时确定调用哪个签名的方法,而重写是在运行时确定这个方法执行哪个类的实现。
# 抽象类和普通类区别?
- 实例化:普通类可以直接实例化对象,而抽象类不能被实例化,只能被继承。
- 方法实现:普通类中的方法可以有具体的实现,而抽象类中的方法可以有实现也可以没有实现。
- 继承:普通类和抽象类在继承规则上完全一样——都只能被单继承(
extends),都可以实现多个接口(implements),这一点两者没有区别。 - 实现限制:普通类可以被其他类继承和使用,而抽象类一般用于作为基类,被其他类继承和扩展使用。
# Java抽象类和接口的区别是什么?
两者的特点:
- 抽象类用于描述类的共同特性和行为,可以有成员变量、构造方法和具体方法。适用于有明显继承关系的场景。
- 接口用于定义行为规范,可以多实现,只能有常量和抽象方法(Java 8 以后可以有默认方法和静态方法)。适用于定义类的能力或功能。
两者的区别:
- 实现方式:实现接口的关键字为implements,继承抽象类的关键字为extends。一个类可以实现多个接口,但一个类只能继承一个抽象类。所以,使用接口可以间接地实现多重继承。
- 方法方式:接口只有定义,不能有方法的实现,java 1.8中可以定义default方法体,而抽象类可以有定义与实现,方法可在抽象类中实现。
- 访问修饰符:接口成员变量默认为
public static final,必须赋初值,不能被修改;接口中的抽象方法默认是public abstract,从 Java 8 起接口可以定义default和static方法(带方法体),从 Java 9 起还可以定义private方法用于辅助 default 方法的实现。抽象类中成员变量默认为 default 访问权限,可在子类中被重新定义,也可被重新赋值;抽象方法被 abstract 修饰,不能被 private、static、synchronized 和 native 等修饰,必须以分号结尾,不带花括号。 - 变量:抽象类可以包含实例变量和静态变量,而接口只能包含常量(即静态常量)。
# 抽象类能加final修饰吗?
不能,Java中的抽象类是用来被继承的,而final修饰符用于禁止类被继承或方法被重写,因此,抽象类和final修饰符是互斥的,不能同时使用。
# 接口里面可以定义哪些方法?
- 抽象方法
抽象方法是接口的核心部分,所有实现接口的类都必须实现这些方法。抽象方法默认是 public 和 abstract,这些修饰符可以省略。
public interface Animal {
    void makeSound();
}
- 默认方法
默认方法是在 Java 8 中引入的,允许接口提供具体实现。实现类可以选择重写默认方法。
public interface Animal {
    void makeSound();

    default void sleep() {
        System.out.println("Sleeping...");
    }
}
- 静态方法
静态方法也是在 Java 8 中引入的,它们属于接口本身,可以通过接口名直接调用,而不需要实现类的对象。
public interface Animal {
    void makeSound();

    static void staticMethod() {
        System.out.println("Static method in interface");
    }
}
- 私有方法
私有方法是在 Java 9 中引入的,用于在接口中为默认方法或其他私有方法提供辅助功能。这些方法不能被实现类访问,只能在接口内部使用。
public interface Animal {
    void makeSound();

    default void sleep() {
        System.out.println("Sleeping...");
        logSleep();
    }

    private void logSleep() {
        System.out.println("Logging sleep");
    }
}
public interface Animal {
    void makeSound();
}
# 抽象类可以被实例化吗?
在Java中,抽象类本身不能被实例化。
这意味着不能使用new关键字直接创建一个抽象类的对象。抽象类的存在主要是为了被继承,它通常包含一个或多个抽象方法(由abstract关键字修饰且无方法体的方法),这些方法需要在子类中被实现。
抽象类可以有构造器,这些构造器在子类实例化时会被调用,以便进行必要的初始化工作。然而,这个过程并不是直接实例化抽象类,而是创建了子类的实例,间接地使用了抽象类的构造器。
例如:
public abstract class AbstractClass {
    public AbstractClass() {
        // 构造器代码
    }

    public abstract void abstractMethod();
}

public class ConcreteClass extends AbstractClass {
    public ConcreteClass() {
        super(); // 调用抽象类的构造器
    }

    @Override
    public void abstractMethod() {
        // 实现抽象方法
    }
}

// 下面的代码可以运行
ConcreteClass obj = new ConcreteClass();
在这个例子中,ConcreteClass继承了AbstractClass并实现了抽象方法abstractMethod()。当我们创建ConcreteClass的实例时,AbstractClass的构造器被调用,但这并不意味着AbstractClass被实例化;实际上,我们创建的是ConcreteClass的一个对象。
简而言之,抽象类不能直接实例化,但通过继承抽象类并实现所有抽象方法的子类是可以被实例化的。
# 接口可以包含构造函数吗?
在接口中,不可以有构造方法,在接口里写入构造方法时,编译器提示:Interfaces cannot have constructors,因为接口不会有自己的实例的,所以不需要有构造函数。
为什么呢?构造函数就是初始化class的属性或者方法,在new的一瞬间自动调用,那么问题来了Java的接口,都不能new 那么要构造函数干嘛呢?根本就没法调用
# 解释Java中的静态变量和静态方法
在Java中,静态变量和静态方法是与类本身关联的,而不是与类的实例(对象)关联。它们在内存中只存在一份,可以被类的所有实例共享。
静态变量
静态变量(也称为类变量)是在类中使用static关键字声明的变量。它们属于类而不是任何具体的对象。主要的特点:
- 共享性:所有该类的实例共享同一个静态变量。如果一个实例修改了静态变量的值,其他实例也会看到这个更改。
- 初始化:静态变量在类被加载时初始化,只会对其进行一次分配内存。
- 访问方式:静态变量可以直接通过类名访问,也可以通过实例访问,但推荐使用类名。
示例:
public class MyClass {
    static int staticVar = 0; // 静态变量

    public MyClass() {
        staticVar++; // 每创建一个对象,静态变量自增
    }

    public static void printStaticVar() {
        System.out.println("Static Var: " + staticVar);
    }
}

// 使用示例
MyClass obj1 = new MyClass();
MyClass obj2 = new MyClass();
MyClass.printStaticVar(); // 输出 Static Var: 2
静态方法
静态方法是在类中使用static关键字声明的方法。类似于静态变量,静态方法也属于类,而不是任何具体的对象。主要的特点:
- 无实例依赖:静态方法可以在没有创建类实例的情况下调用。对于静态方法来说,不能直接访问非静态的成员变量或方法,因为静态方法没有上下文的实例。
- 访问静态成员:静态方法可以直接调用其他静态变量和静态方法,但不能直接访问非静态成员。
- 多态性:静态方法不支持重写(Override),但可以被隐藏(Hide)。
public class MyClass {
    static int count = 0;

    // 静态方法
    public static void incrementCount() {
        count++;
    }

    public static void displayCount() {
        System.out.println("Count: " + count);
    }
}

// 使用示例
MyClass.incrementCount(); // 调用静态方法
MyClass.displayCount();   // 输出 Count: 1
使用场景
- 静态变量:常用于需要在所有对象间共享的数据,如计数器、常量等。
- 静态方法:常用于助手方法(utility methods)、获取类级别的信息或者是没有依赖于实例的数据处理。
# 非静态内部类和静态内部类的区别?
区别包括:
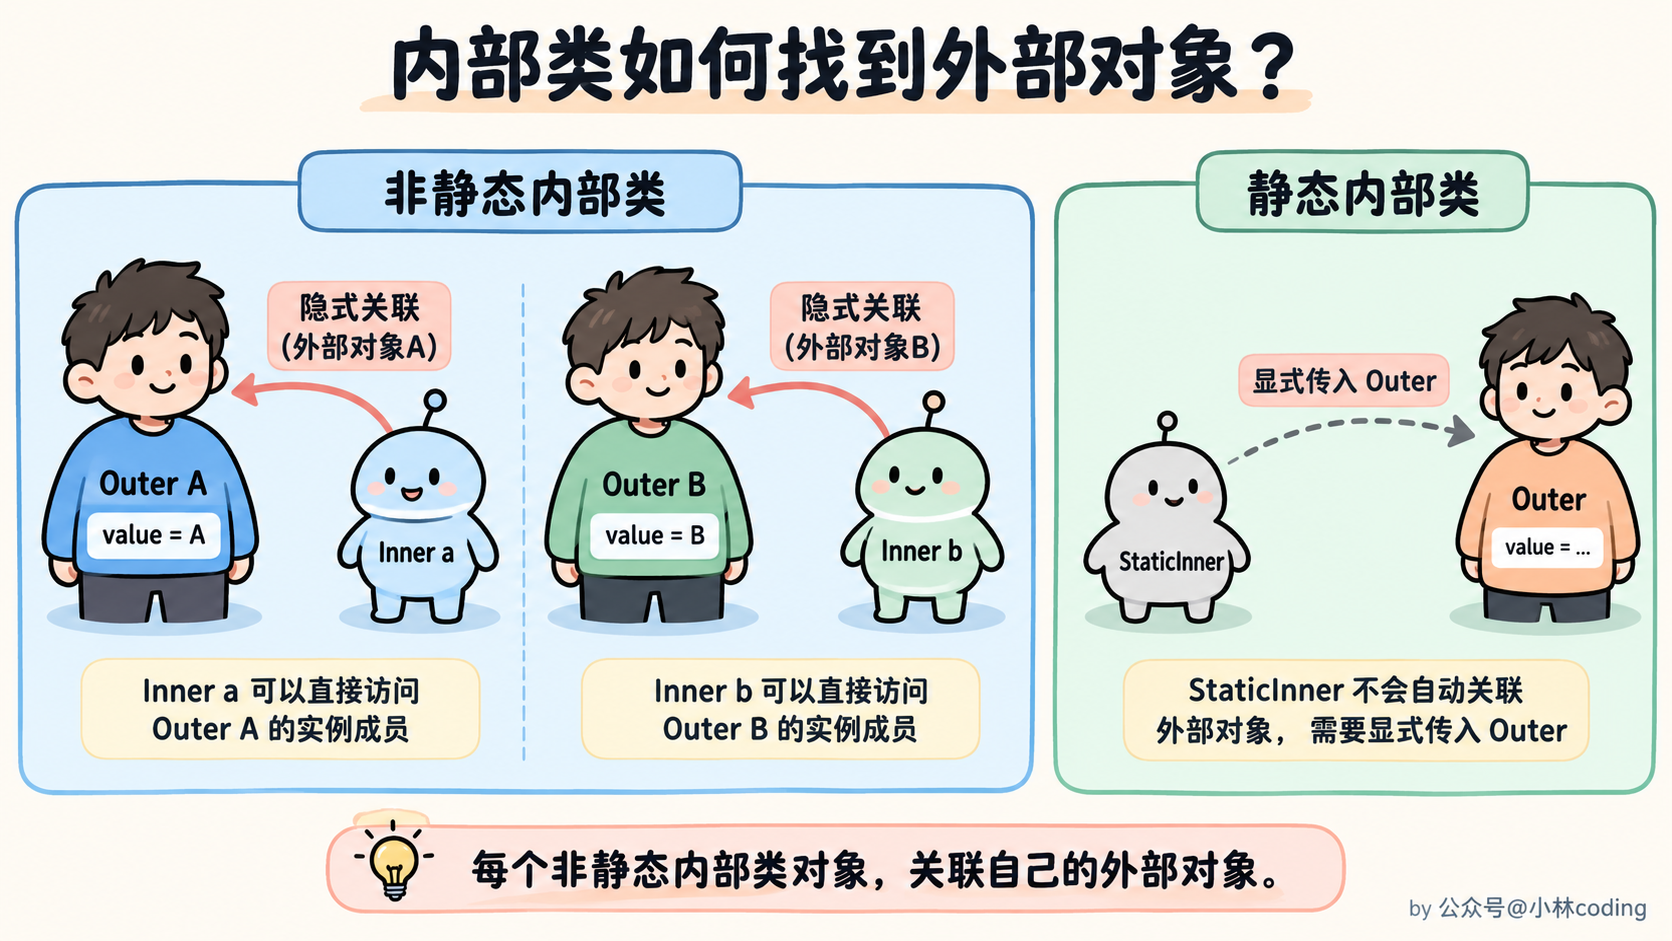
- 非静态内部类依赖于外部类的实例,而静态内部类不依赖于外部类的实例。
- 非静态内部类可以直接访问外部类的所有成员(包括实例变量和方法);静态内部类可以直接访问外部类的静态成员,访问外部类的实例成员则必须通过外部类的实例引用。
- 非静态内部类不能定义静态成员(Java 16 之前),而静态内部类可以定义静态成员。
- 非静态内部类在外部类实例化后才能实例化,而静态内部类可以独立实例化。
- 静态内部类和非静态内部类都可以访问外部类的私有成员(因为编译器会为嵌套类提供访问权限)——两者的区别在于静态内部类访问外部类的私有实例成员时必须先拿到外部类实例,而不是像非静态内部类那样能直接访问。
# 非静态内部类可以直接访问外部方法,编译器是怎么做到的?
非静态内部类可以直接访问外部方法是因为编译器在生成字节码时会为非静态内部类维护一个指向外部类实例的引用。
这个引用使得非静态内部类能够访问外部类的实例变量和方法。编译器会在生成非静态内部类的构造方法时,将外部类实例作为参数传入,并在内部类的实例化过程中建立外部类实例与内部类实例之间的联系,从而实现直接访问外部方法的功能。
# 关键字
# Java 中 final 作用是什么?
final主要用来修饰类、方法和变量,分别表示不能继承、不能重写、不能再次赋值。
修饰类
final修饰的类不能被继承,比如String就是final类。这样可以避免子类重写方法,改变这个类原本的行为。
不过,类被final修饰,不代表它的对象就一定不可变。如果类里还有可以修改字段的方法,对象的内容仍然可以改变。
修饰方法
final修饰的方法不能被子类重写,但可以正常被继承和调用,也可以定义不同参数列表的同名方法,也就是重载。
比如Object的getClass方法就是final方法,子类不能通过重写改变它返回对象实际类型的行为。
修饰变量
final变量只能被赋值一次。局部变量必须在使用前完成赋值;final实例字段可以在声明、实例初始化块或者构造方法中赋值,但必须保证构造完成时已经赋值,而且不能重复赋值。
对于基本类型,不能再改变变量保存的值;对于引用类型,不能再让变量指向另一个对象,但对象内部的数据可能仍然可以修改:
final int num = 10;
// num = 20; // 编译不通过

final StringBuilder builder = new StringBuilder("Hello");
builder.append(" World"); // 可以,修改的是对象内部的内容
// builder = new StringBuilder(); // 编译不通过,不能重新赋值
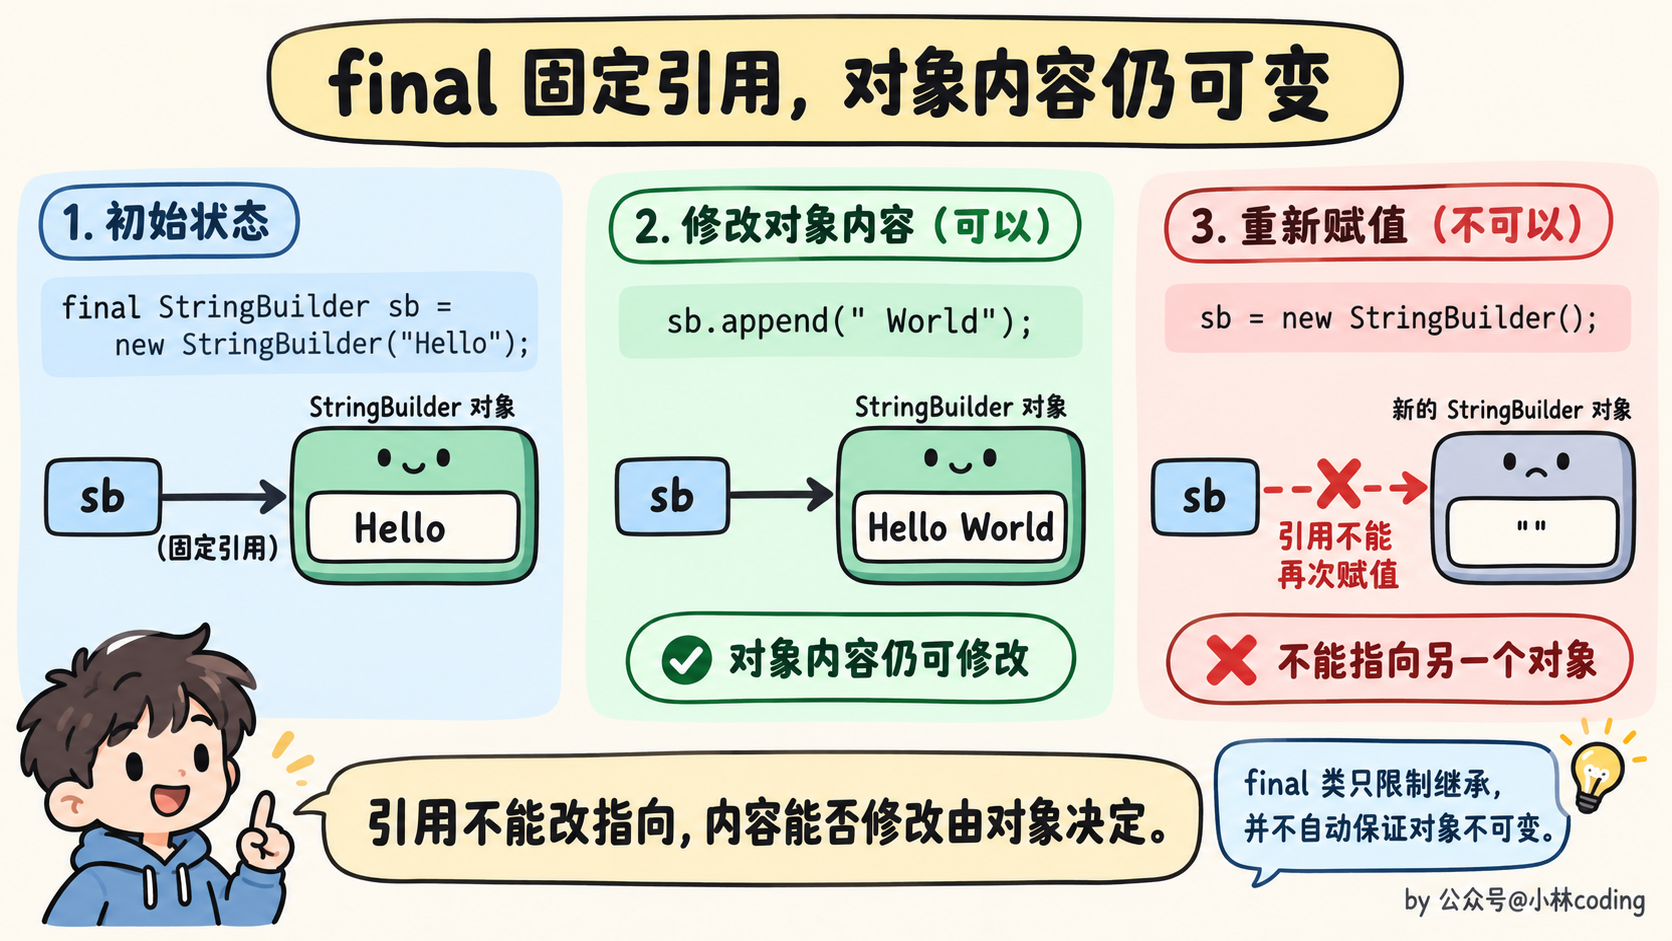
另外,final变量不一定都是编译期常量。只有基本类型或者String类型的final变量,并且使用常量表达式初始化,才是Java所说的常量变量。比如final int num = 10是,但final int num = getNum()不是。
为什么String是不可变的?
String不可变不是只靠类上的final。它还把内部存储封装起来,不提供修改自身内容的公开方法,构造和对外传递数据时也会避免把可修改的内部存储直接暴露出去。final类主要是防止子类通过继承改变这些行为。
所以,设计不可变对象时,需要同时考虑字段、可变成员的防御性拷贝和对外接口,不能只给类或者引用加一个final就认为完成了。
# Java 中 static的作用是什么?
static 关键字主要用于修饰类的成员(变量、方法、代码块)和内部类,其核心作用是将成员与类本身关联,而非与类的实例(对象)关联。具体作用如下:
1、修饰变量
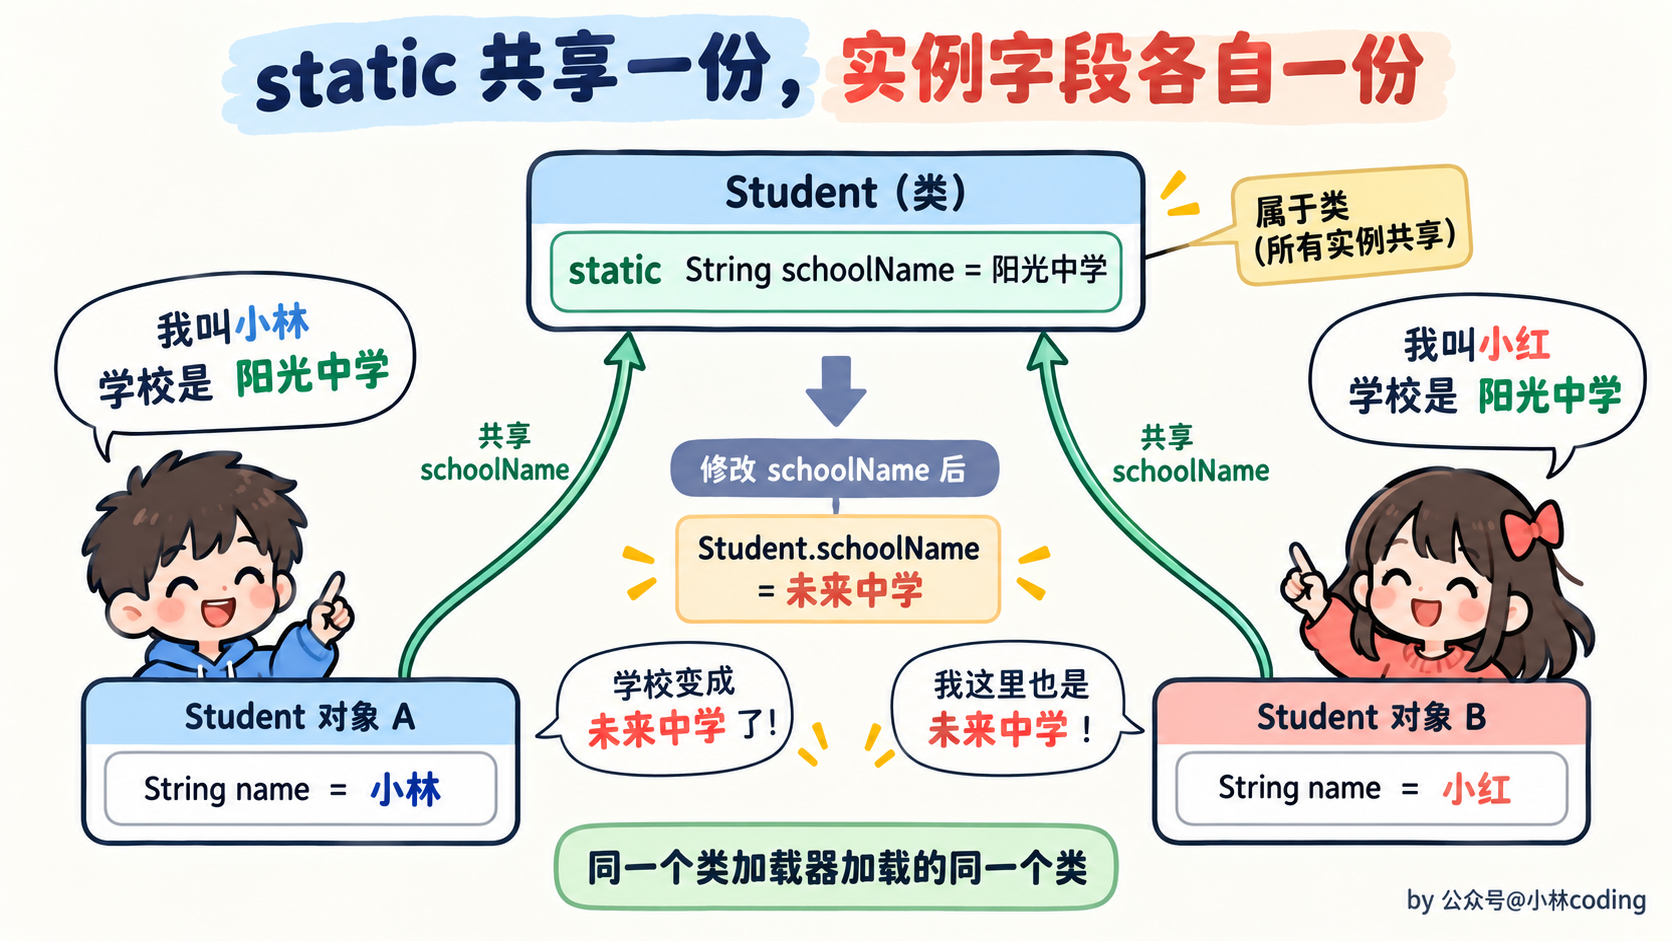
被 static 修饰的变量属于类本身,而非类的某个实例。所有对象共享同一份静态变量,内存中只存在一份副本。可以通过 类名.变量名 直接访问,无需创建对象(也可通过对象访问,但不推荐)。
通常用于存储所有对象共享的数据,如常量、计数器等。
public class Student {
    // 静态变量(所有学生共享同一个学校名称)
    public static String schoolName = "阳光中学";
    // 实例变量(每个学生有自己的姓名)
    private String name;
}

// 访问静态变量
public class Test {
    public static void main(String[] args) {
        System.out.println(Student.schoolName); // 直接通过类名访问
    }
}
2、修饰方法
静态方法属于类,不属于任何实例,因此不能直接访问类中的非静态成员(变量 / 方法)(因为非静态成员依赖于对象存在),但可以访问静态成员。通过 类名.方法名 直接调用,无需创建对象。
通常用于工具类方法(如 Math.random())、工厂方法等,不需要依赖对象状态即可完成操作。
public class MathUtils {
    // 静态方法(无需创建对象即可调用)
    public static int add(int a, int b) {
        return a + b;
    }
}

// 调用静态方法
public class Test {
    public static void main(String[] args) {
        int result = MathUtils.add(2, 3); // 直接通过类名调用
    }
}
3、修饰代码块
静态代码块在类初始化阶段(即执行 <clinit> 时)执行,且只执行一次(优于对象构造方法),用于初始化静态变量或执行类级别的预处理操作。JVM 的类生命周期为:加载 → 链接(验证、准备、解析)→ 初始化,静态代码块属于"初始化"阶段而非"加载"阶段。
多个静态代码块按定义顺序执行,且先于非静态代码块和构造方法。
public class Database {
    private static String url;

    // 静态代码块:初始化静态变量
    static {
        url = "jdbc:mysql://localhost:3306/test";
        System.out.println("数据库连接地址初始化完成");
    }
}
4、修饰内部类
静态内部类不依赖于外部类的实例,可以独立存在,不能直接访问外部类的非静态成员(需通过外部类实例访问)。
当内部类与外部类的实例无关时使用,避免内部类持有外部类的引用导致的内存泄漏。
public class OuterClass {
    private static int staticVar = 10;
    private int instanceVar = 20;

    // 静态内部类
    public static class StaticInnerClass {
        public void print() {
            System.out.println(staticVar); // 可访问外部类静态变量
            // System.out.println(instanceVar); // 错误:不能直接访问非静态变量
        }
    }
}

// 使用静态内部类
public class Test {
    public static void main(String[] args) {
        OuterClass.StaticInnerClass inner = new OuterClass.StaticInnerClass();
        inner.print();
    }
}
# 深拷贝和浅拷贝
# 深拷贝和浅拷贝的区别?
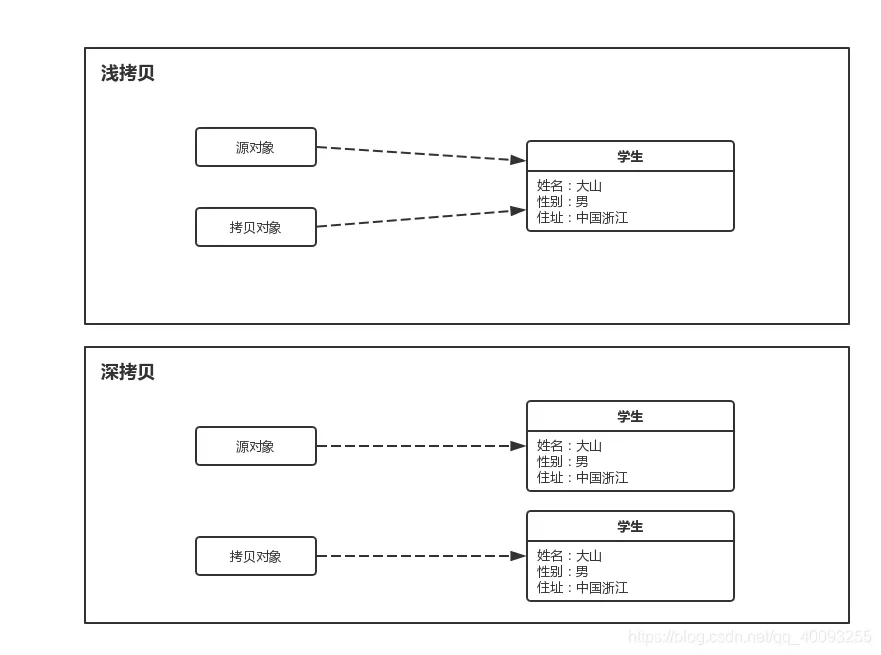
- 浅拷贝是指只复制对象本身和其内部的值类型字段,但不会复制对象内部的引用类型字段。换句话说,浅拷贝只是创建一个新的对象,然后将原对象的字段值复制到新对象中,但如果原对象内部有引用类型的字段,只是将引用复制到新对象中,两个对象指向的是同一个引用对象。
- 深拷贝是指在复制对象的同时,将对象内部的所有引用类型字段的内容也复制一份,而不是共享引用。换句话说,深拷贝会递归复制对象内部所有引用类型的字段,生成一个全新的对象以及其内部的所有对象。
# 实现深拷贝的三种方法是什么?
在 Java 中,实现对象深拷贝的方法有以下几种主要方式:
实现 Cloneable 接口并重写 clone() 方法
这种方法要求对象及其所有引用类型字段都实现 Cloneable 接口,并且重写 clone() 方法。在 clone() 方法中,通过递归克隆引用类型字段来实现深拷贝。
class MyClass implements Cloneable {
    private String field1;
    private NestedClass nestedObject;

    @Override
    protected Object clone() throws CloneNotSupportedException {
        MyClass cloned = (MyClass) super.clone();
        cloned.nestedObject = (NestedClass) nestedObject.clone(); // 深拷贝内部的引用对象
        return cloned;
    }
}

class NestedClass implements Cloneable {
    private int nestedField;

    @Override
    protected Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}
使用序列化和反序列化
通过将对象序列化为字节流,再从字节流反序列化为对象来实现深拷贝。要求对象及其所有引用类型字段都实现 Serializable 接口。
import java.io.*;

class MyClass implements Serializable {
    private String field1;
    private NestedClass nestedObject;

    public MyClass deepCopy() {
        try {
            ByteArrayOutputStream bos = new ByteArrayOutputStream();
            ObjectOutputStream oos = new ObjectOutputStream(bos);
            oos.writeObject(this);
            oos.flush();
            oos.close();

            ByteArrayInputStream bis = new ByteArrayInputStream(bos.toByteArray());
            ObjectInputStream ois = new ObjectInputStream(bis);
            return (MyClass) ois.readObject();
        } catch (IOException | ClassNotFoundException e) {
            e.printStackTrace();
            return null;
        }
    }
}

class NestedClass implements Serializable {
    private int nestedField;
}
手动递归复制
针对特定对象结构,手动递归复制对象及其引用类型字段。适用于对象结构复杂度不高的情况。
class MyClass {
    private String field1;
    private NestedClass nestedObject;

    public MyClass deepCopy() {
        MyClass copy = new MyClass();
        copy.setField1(this.field1);
        copy.setNestedObject(this.nestedObject.deepCopy());
        return copy;
    }
}

class NestedClass {
    private int nestedField;

    public NestedClass deepCopy() {
        NestedClass copy = new NestedClass();
        copy.setNestedField(this.nestedField);
        return copy;
    }
}
# 泛型
# 什么是泛型?
泛型就是在定义类、接口或者方法时,先用一个类型参数来表示具体的数据类型,等使用时再指定。比如List<String>,就是告诉编译器,这个集合里存放的是String。
泛型主要解决两个问题:一是复用代码,二是把类型检查提前到编译阶段。
为什么需要泛型?
如果不用泛型,集合中可以放入不同类型的对象,取出时就需要自己强制转换,稍不注意就会出现ClassCastException。
List list = new ArrayList();
list.add("小林");
list.add(100);

String name = (String) list.get(0); // 需要强制转换
String num = (String) list.get(1);  // 运行时抛出ClassCastException
使用泛型之后,编译器就能检查放进去的类型,取出来时也不用手动转换:
List<String> list = new ArrayList<>();
list.add("小林");
// list.add(100); // 编译不通过,提前发现类型错误

String name = list.get(0);
代码复用也是同样的道理。比如定义一个存放数据的Box,不用分别写StringBox、IntegerBox,用一个泛型类就可以了:
class Box<T> {
    private T value;

    public void set(T value) {
        this.value = value;
    }

    public T get() {
        return value;
    }
}
使用时,Box<String>存放字符串,Box<Integer>存放整数,复用的都是同一份代码。
泛型在运行时还存在吗?
Java泛型主要通过类型擦除来实现。编译时会进行类型检查,生成字节码时,会把类型参数替换成它的上界,没有指定上界时就替换成Object,并在必要的位置插入类型转换。
比如List<String>和List<Integer>,运行时都是同一个ArrayList类,不会分别生成两个类:
List<String> names = new ArrayList<>();
List<Integer> numbers = new ArrayList<>();
System.out.println(names.getClass() == numbers.getClass()); // true
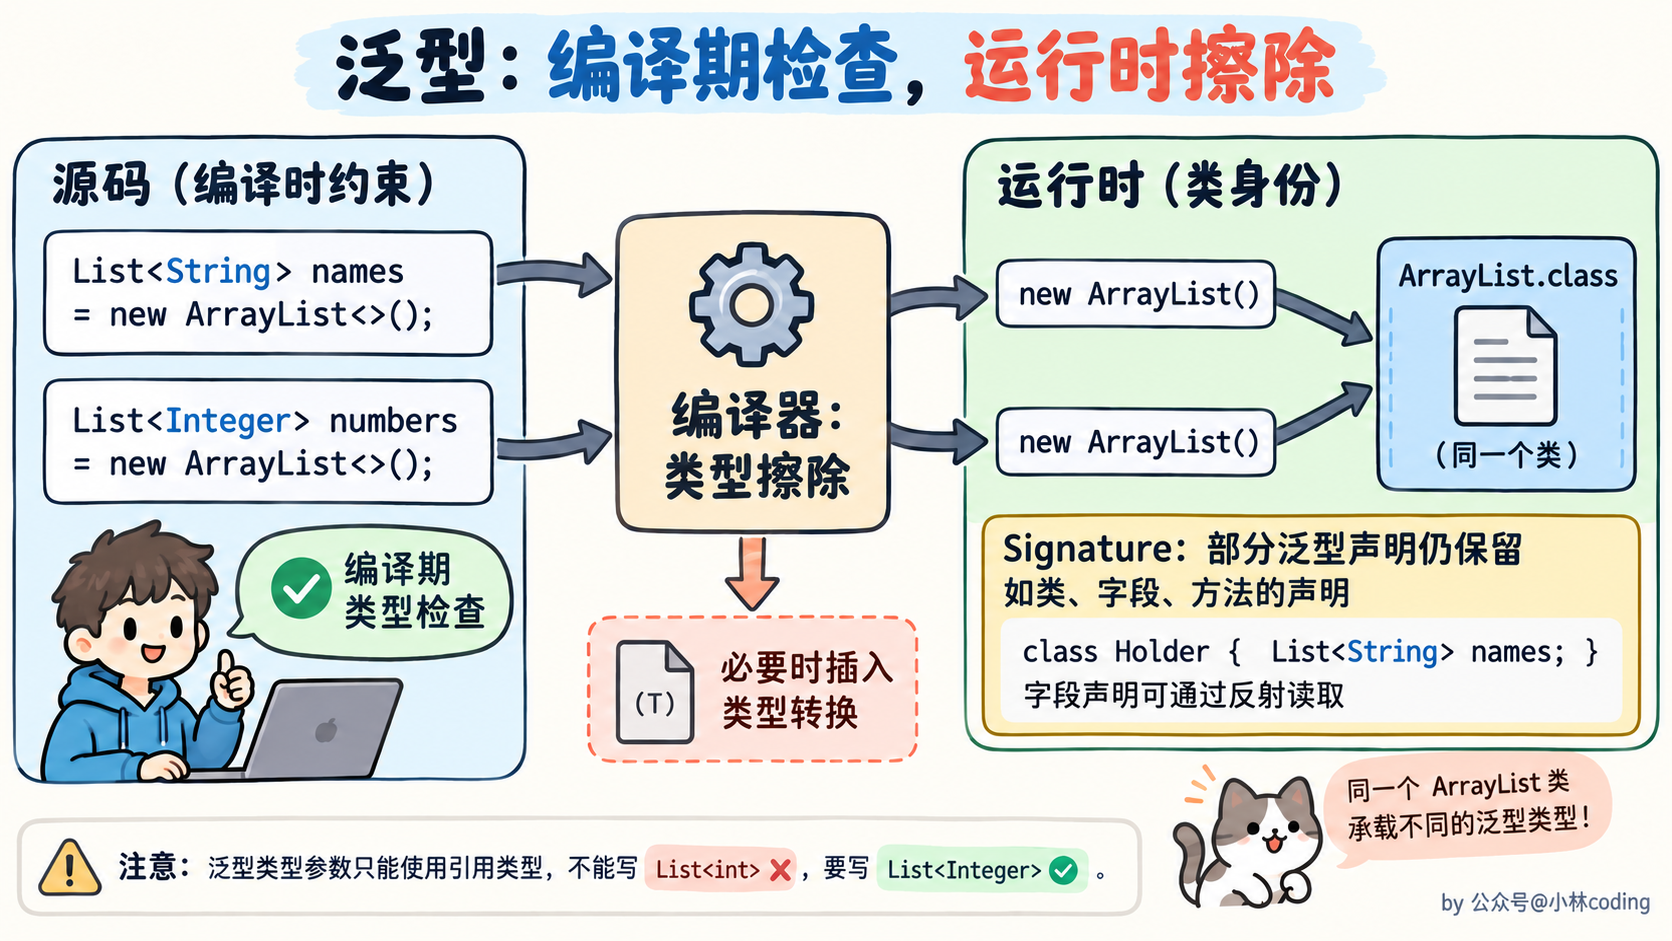
不过,类型擦除不代表所有泛型信息都消失了。类、字段和方法声明中的部分泛型信息会保存在class文件的Signature属性中,可以通过反射读取。但不能仅凭一个普通的new ArrayList<String>()对象,就直接获知它的类型参数是String。
还有两个常见的注意点:
- 泛型类型参数只能使用引用类型,不能写
List<int>,要写List<Integer>。 - Integer虽然是Number的子类,但
List<Integer>不是List<Number>的子类。如果方法要接收不同数值类型的列表,可以根据读写需求使用通配符,比如List<? extends Number>用于读取Number,List<? super Integer>允许写入Integer。
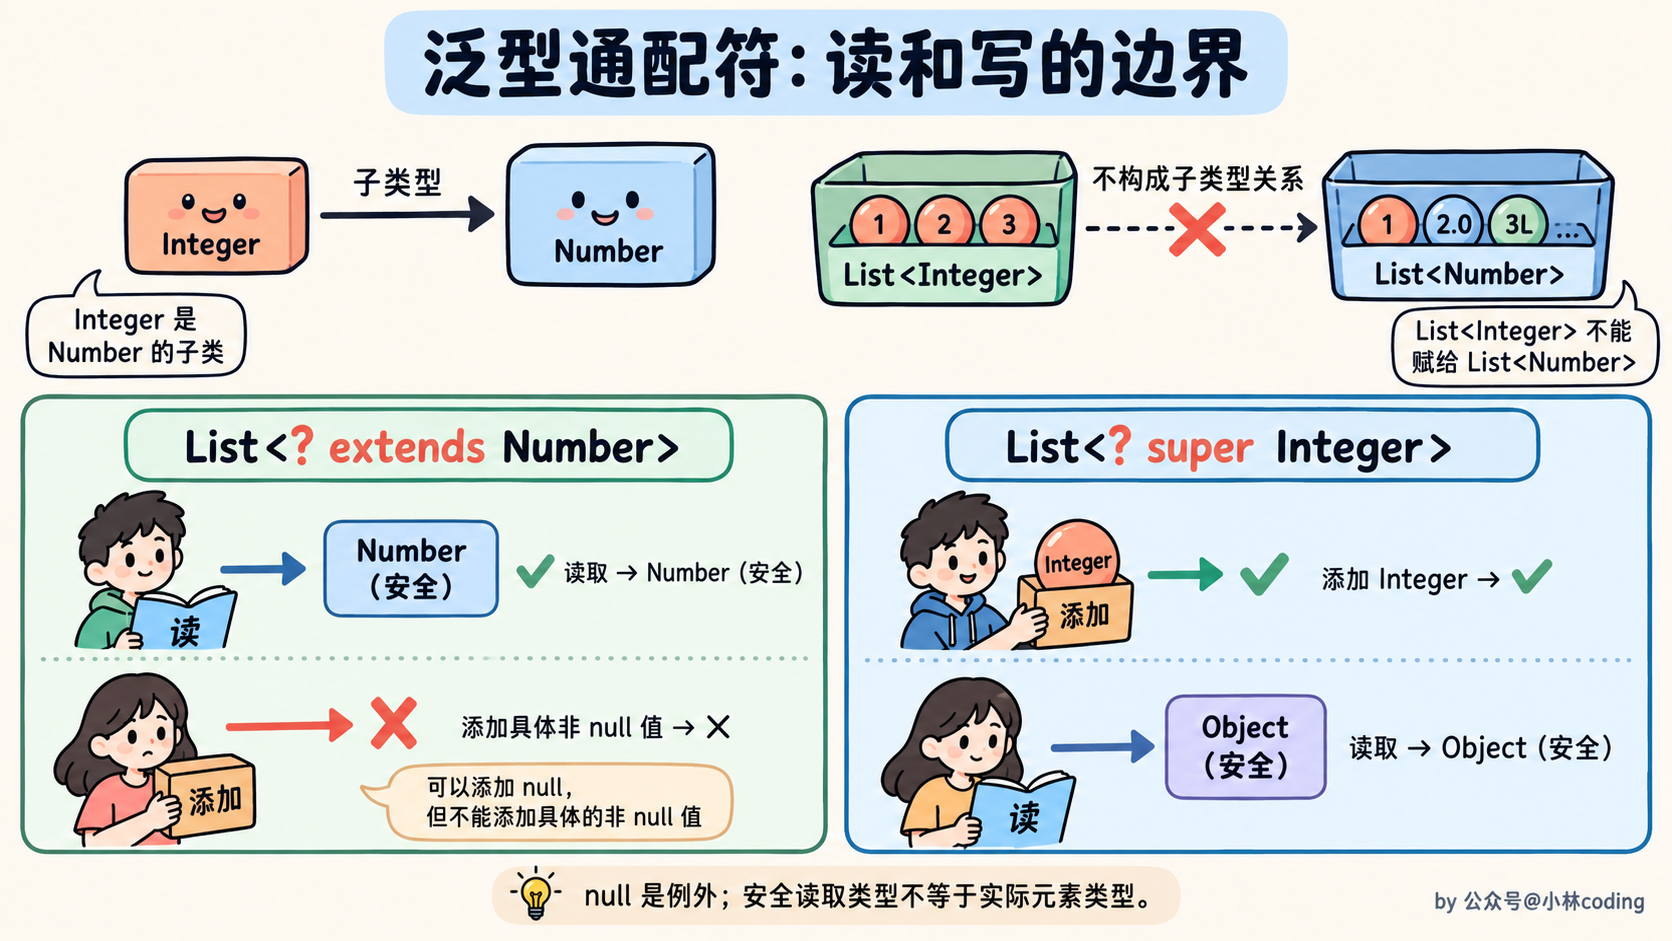
正常使用泛型可以减少类型转换错误,但如果混用原始类型、进行未经检查的转换,仍然可能在运行时出现ClassCastException。
# 对象
# java创建对象有哪些方式?
在Java中,创建对象的方式有多种,常见的包括:
1、使用new关键字:这是最常见、最基础的创建对象方式。通过调用类的构造器来实例化对象。
// 定义一个类
public class Person {
    private String name;

    public Person() {} // 默认构造器
    public Person(String name) { // 带参构造器
        this.name = name;
    }

    public void sayHello() {
        System.out.println("Hello, " + name);
    }
}

// 使用 new 创建对象
public class Main {
    public static void main(String[] args) {
        Person person1 = new Person(); // 调用无参构造
        Person person2 = new Person("Alice"); // 调用有参构造

        person2.sayHello(); // 输出: Hello, Alice
    }
}
优点是简单、直接、明确。缺点是紧密耦合,必须知道具体的类名。
2、使用Class类的newInstance()方法:通过 Java 的反射 API,在运行时动态地创建对象。这种方式不需要在编译时知道具体的类。
MyClass obj = (MyClass) Class.forName("com.example.MyClass").getDeclaredConstructor().newInstance();
应用场景:框架设计(如 Spring 的 IOC 容器)、动态代理等。
注意:Class.newInstance() 在 JDK 9 后被标记为过时,因为它只能调用无参公有构造器,且会抛出所有受检异常。推荐使用 Constructor.newInstance(),更强大也更灵活。
使用Constructor类的newInstance()方法:同样是通过反射机制,可以使用Constructor类的newInstance()方法创建对象。
Constructor<MyClass> constructor = MyClass.class.getConstructor();
MyClass obj = constructor.newInstance();
3、使用clone()方法:通过实现 Cloneable 接口并重写 Object 类的 clone() 方法,可以基于一个现有对象(原型)创建一个新的副本对象。
// 实现 Cloneable 接口
public class Person implements Cloneable {
    private String name;

    // ... 构造器和其他方法 ...

    @Override
    protected Object clone() throws CloneNotSupportedException {
        return super.clone(); // 浅拷贝
    }
}

public class Main {
    public static void main(String[] args) {
        Person original = new Person("Charlie");
        try {
            Person copy = (Person) original.clone(); // 创建副本
            copy.sayHello(); // 输出: Hello, Charlie
        } catch (CloneNotSupportedException e) {
            e.printStackTrace();
        }
    }
}
Object.clone() 默认是浅拷贝,对于引用类型的字段,复制的是引用地址,而不是引用的对象本身。如果需要深拷贝,必须在 clone() 方法中手动对引用对象进行克隆。
4、使用反序列化:通过 ObjectInputStream 从一个字节流(通常是文件或网络)中重建一个对象。
import java.io.*;

// 必须实现 Serializable 接口
public class Person implements Serializable {
    private String name;
    // ... 构造器和其他方法 ...
}

public class Main {
    public static void main(String[] args) {
        Person personToSave = new Person("David");

        // 序列化对象到文件
        try (ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream("person.dat"))) {
            oos.writeObject(personToSave);
        } catch (IOException e) {
            e.printStackTrace();
        }

        // 从文件反序列化对象
        try (ObjectInputStream ois = new ObjectInputStream(new FileInputStream("person.dat"))) {
            Person restoredPerson = (Person) ois.readObject(); // 创建新对象
            restoredPerson.sayHello(); // 输出: Hello, David
        } catch (IOException | ClassNotFoundException e) {
            e.printStackTrace();
        }
    }
}
特点是不会调用类的任何构造器,类必须实现 java.io.Serializable 接口。
5、使用工厂模式:这是一种设计模式,不直接使用 new,而是通过一个方法来返回对象实例。getInstance()、valueOf() 等都是常见的工厂方法。
public class Person {
    private String name;

    private Person(String name) { // 构造器可以是私有的
        this.name = name;
    }

    // 静态工厂方法
    public static Person createPerson(String name) {
        // 这里可以做一些额外的逻辑,比如缓存、日志、返回子类实例等
        return new Person(name);
    }
}

public class Main {
    public static void main(String[] args) {
        // 不是用 new,而是用工厂方法创建
        Person person = Person.createPerson("Eva");
        person.sayHello();
    }
}
优点是将对象的创建与使用分离,降低耦合,还可以隐藏创建对象的复杂逻辑(如池化技术、缓存)。
Java 标准库中的例子:Integer.valueOf(int),Calendar.getInstance()。
最后来个,总结对比:
| 方式 | 核心原理 | 是否调用构造器? | 特点与应用场景 |
|---|---|---|---|
new 关键字 | JVM 指令 | 是 | 最标准、最常用,紧密耦合 |
| 反射 | 运行时类信息 | 是 (Constructor) | 灵活,解耦,用于框架 |
clone() | 复制现有对象 | 否 | 基于原型创建副本,需实现 Cloneable |
| 反序列化 | 从字节流恢复 | 否 | 用于持久化和网络通信,需实现 Serializable |
| 工厂模式 | 方法封装 new | 是 (在方法内) | 解耦,隐藏创建逻辑,控制实例 |
# Java创建对象除了new还有别的什么方式?
- 通过反射创建对象:通过 Java 的反射机制可以在运行时动态地创建对象。可以使用 Class 类的 newInstance() 方法或者通过 Constructor 类来创建对象。
public class MyClass {
    public MyClass() {
        // Constructor
    }
}

public class Main {
    public static void main(String[] args) throws Exception {
        Class<?> clazz = MyClass.class;
        MyClass obj = (MyClass) clazz.getDeclaredConstructor().newInstance();
    }
}
- 通过反序列化创建对象:通过将对象序列化(保存到文件或网络传输)然后再反序列化(从文件或网络传输中读取对象)的方式来创建对象,对象能被序列化和反序列化的前提是类实现Serializable接口。
import java.io.*;

public class MyClass implements Serializable {
    // Class definition
}

public class Main {
    public static void main(String[] args) throws Exception {
        // Serialize object
        MyClass obj = new MyClass();
        ObjectOutputStream out = new ObjectOutputStream(new FileOutputStream("object.ser"));
        out.writeObject(obj);
        out.close();

        // Deserialize object
        ObjectInputStream in = new ObjectInputStream(new FileInputStream("object.ser"));
        MyClass newObj = (MyClass) in.readObject();
        in.close();
    }
}
- 通过clone创建对象:所有 Java 对象都继承自 Object 类,Object 类中有一个 clone() 方法,可以用来创建对象的副本,要使用 clone 方法,我们必须先实现 Cloneable 接口并实现其定义的 clone 方法。
public class MyClass implements Cloneable {
    @Override
    public Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}

public class Main {
    public static void main(String[] args) throws CloneNotSupportedException {
        MyClass obj1 = new MyClass();
        MyClass obj2 = (MyClass) obj1.clone();
    }
}
# New出的对象什么时候回收?
通过new创建的对象,一般由垃圾回收器负责回收。判断它能不能被回收,主要看它是否还可达;至于什么时候实际回收,由GC的执行时机决定。
怎么判断对象还在不在使用?
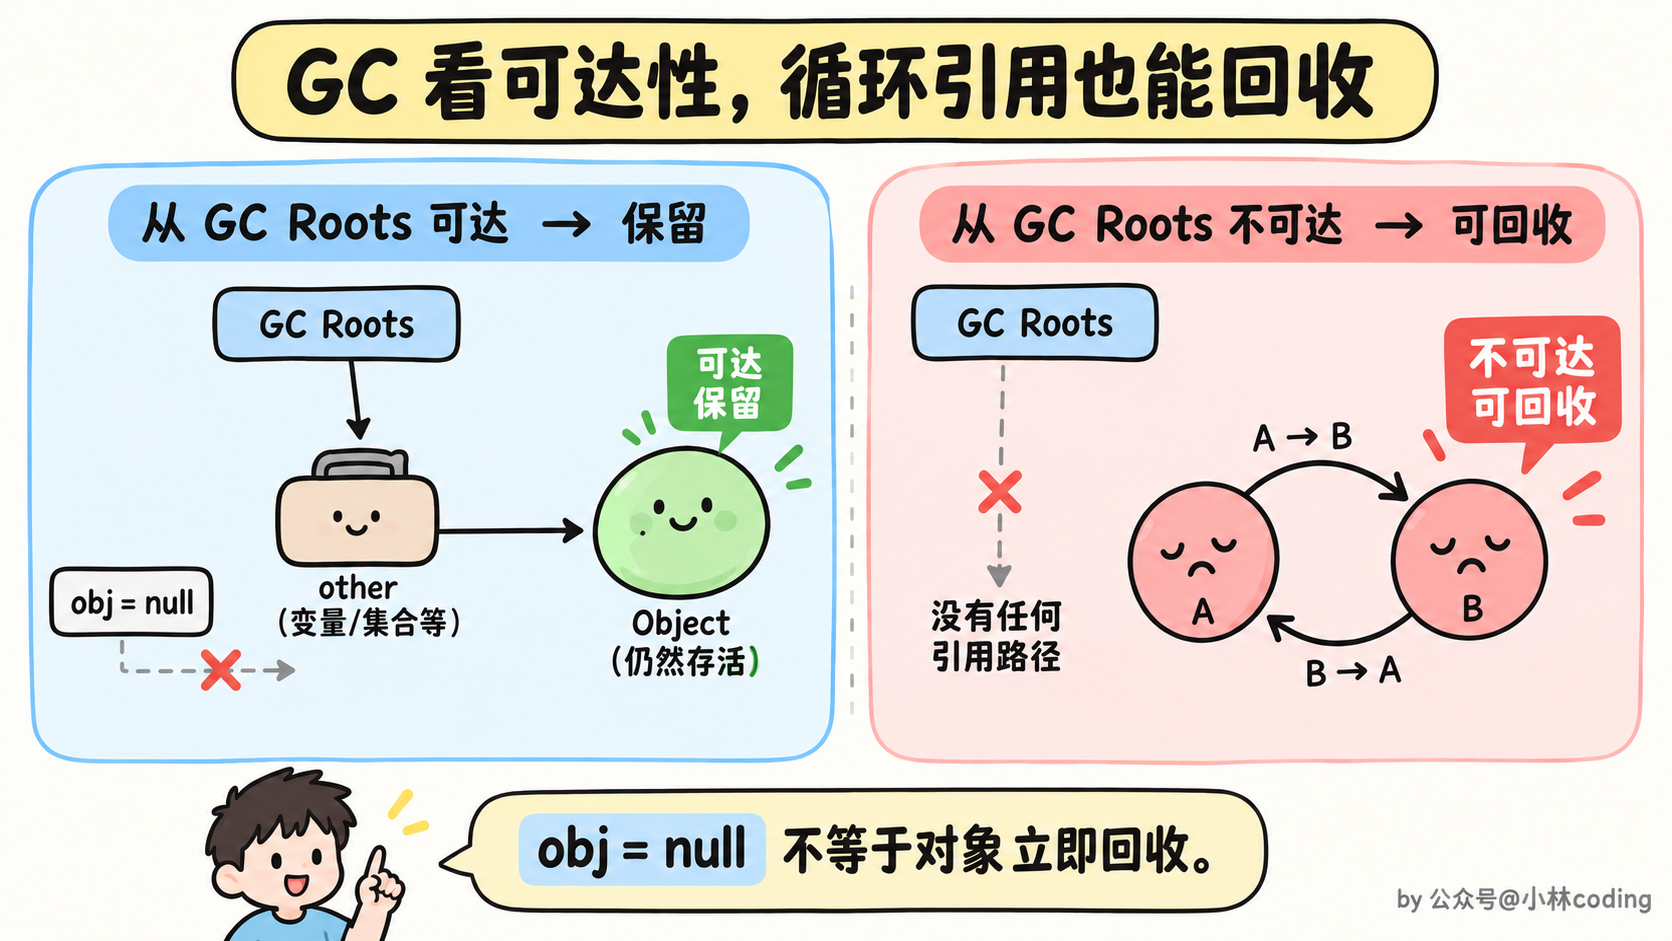
HotSpot主要通过可达性分析判断对象是否存活。从GC Roots出发,沿着引用关系寻找对象,如果某个对象已经不能通过强引用链到达,就通常可以作为垃圾回收的候选对象。软引用、弱引用等特殊引用还会按各自规则处理。
常见的GC Roots包括活动线程栈中的引用、已加载类的静态字段引用,以及JNI全局引用等。
Object obj = new Object();
Object other = obj;

obj = null;   // other仍然引用这个对象,不能因此回收
other = null; // 假设没有其他引用,对象才可能成为回收候选
所以,把一个变量设为null,只是断开这一条引用,不代表对象马上就会被回收。如果它还被静态变量、集合或者其他对象引用,就可能一直存活。
两个对象互相引用,会不会无法回收?
不会仅仅因为循环引用就无法回收。比如A引用B,B也引用A,但从GC Roots出发已经无法到达它们,那么这两个对象仍然可以被回收。这也是可达性分析和简单引用计数的区别。
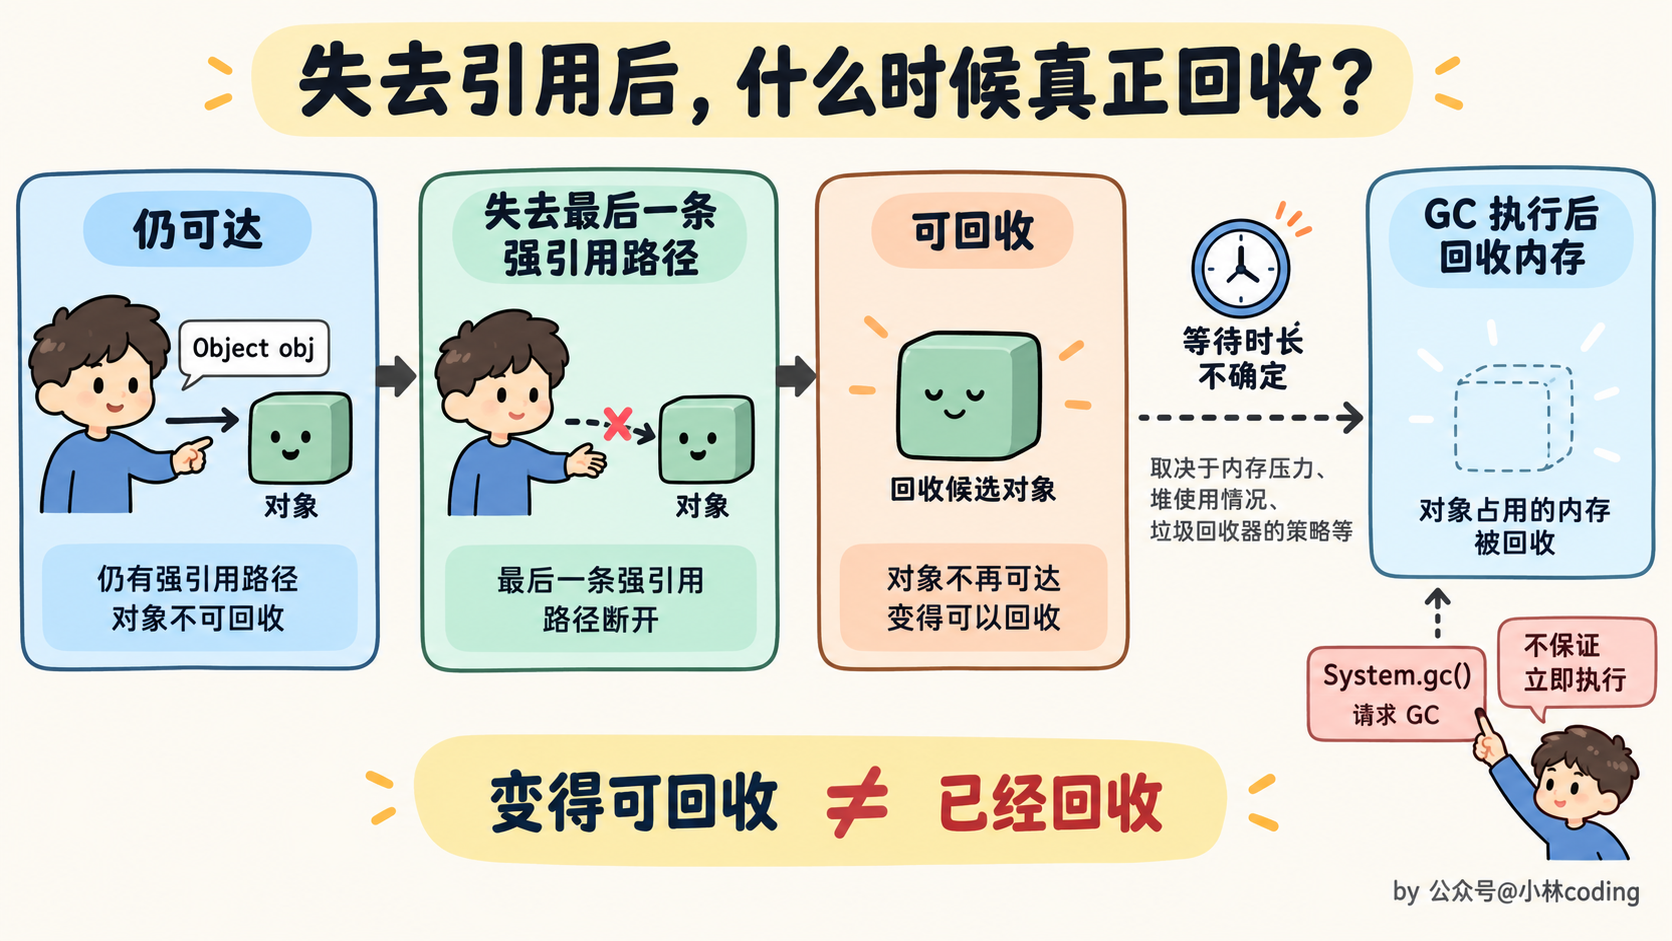
对象不可达后,什么时候实际回收?
不一定马上回收,要看什么时候触发GC,以及这次GC是否处理对象所在的区域。内存分配压力、堆使用情况、垃圾回收器的策略等,都会影响回收时机。
调用System.gc()也只是请求JVM尝试进行垃圾回收,不保证某个对象会立刻被回收,因此不能依赖它控制资源释放。
还有一点,垃圾回收主要负责对象占用的内存,文件、数据库连接、Socket这些资源,应该通过close或者try-with-resources及时释放。不要依赖finalize,它的执行时机没有保证,也不能保证一定执行;这个机制已经过时,Java 18起被标记为待移除。
# 如何获取私有对象?
在 Java 中,私有对象通常指的是类中被声明为 private 的成员变量或方法。由于 private 访问修饰符的限制,这些成员只能在其所在的类内部被访问。
不过,可以通过下面两种方式来间接获取私有对象。
- 使用公共访问器方法(getter 方法):如果类的设计者遵循良好的编程规范,通常会为私有成员变量提供公共的访问器方法(即
getter方法),通过调用这些方法可以安全地获取私有对象。
class MyClass {
    // 私有成员变量
    private String privateField = "私有字段的值";

    // 公共的 getter 方法
    public String getPrivateField() {
        return privateField;
    }
}

public class Main {
    public static void main(String[] args) {
        MyClass obj = new MyClass();
        // 通过调用 getter 方法获取私有对象
        String value = obj.getPrivateField();
        System.out.println(value);
    }
}
- 反射机制。反射机制允许在运行时检查和修改类、方法、字段等信息,通过反射可以绕过
private访问修饰符的限制来获取私有对象。
import java.lang.reflect.Field;

class MyClass {
    private String privateField = "私有字段的值";
}

public class Main {
    public static void main(String[] args) throws NoSuchFieldException, IllegalAccessException {
        MyClass obj = new MyClass();
        // 获取 Class 对象
        Class<?> clazz = obj.getClass();
        // 获取私有字段
        Field privateField = clazz.getDeclaredField("privateField");
        // 设置可访问性
        privateField.setAccessible(true);
        // 获取私有字段的值
        String value = (String) privateField.get(obj);
        System.out.println(value);
    }
}
# 反射
# 什么是反射?
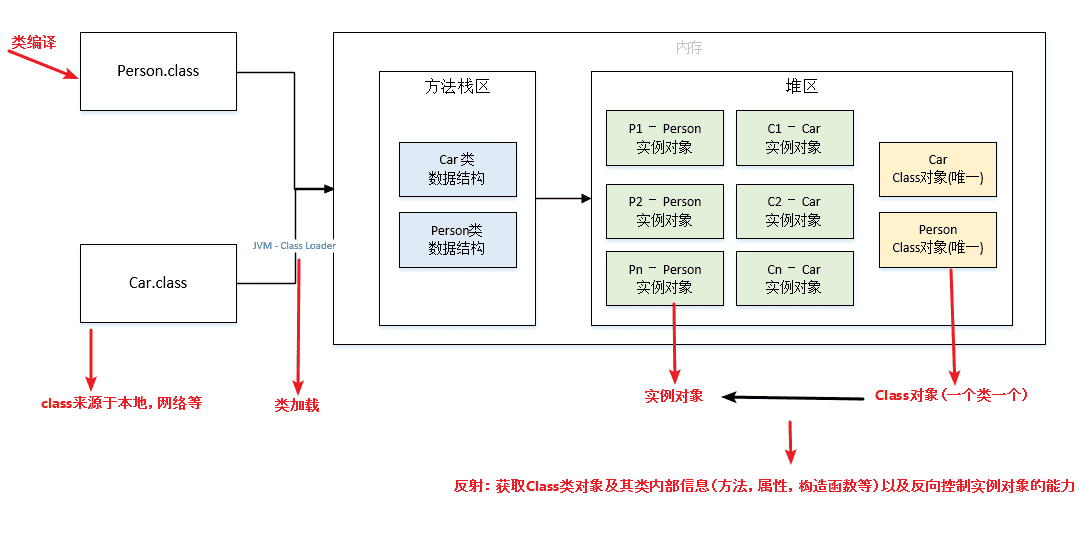
反射就是在程序运行时获取类的结构信息,并动态创建对象、调用方法或者访问字段的机制。比如编译时没有写死要调用哪个类,而是在运行时读取配置,再根据类名找到这个类,就可以用到反射。
Java反射主要围绕Class对象展开,通过它可以获取构造方法、方法、字段等信息:
- Constructor:用于调用构造方法,创建对象。
- Method:用于获取方法信息,并通过invoke调用方法。
- Field:用于读取或者修改字段值。
比如,正常调用一个方法时,我们直接写user.sayHello();使用反射,则是先找到对应的Method,再调用它:
public class User {
    public String sayHello(String name) {
        return "你好," + name;
    }

    public static void main(String[] args) throws Exception {
        Class<?> clazz = Class.forName("User"); // 有包名时需要使用完整类名
        Object user = clazz.getDeclaredConstructor().newInstance();

        java.lang.reflect.Method method =
            clazz.getMethod("sayHello", String.class);
        Object result = method.invoke(user, "小林");
        System.out.println(result); // 你好,小林
    }
}
框架里很常见这种做法。比如Spring可以根据配置和注解创建对象、进行依赖注入;ORM框架可以读取字段信息,把数据库记录映射成对象。
反射能随意访问私有成员吗?
不能说完全没有限制。getMethod主要获取public方法,包括继承的方法;getDeclaredMethod可以获取当前类声明的方法,包括private方法,但不包含继承来的方法。能获取方法信息,不代表就有权限调用它。
访问私有成员时,通常需要通过setAccessible(true)尝试关闭语言层面的访问检查,但仍然受到权限和模块封装的限制。Java 9引入模块系统后,如果目标包没有向调用方开放,可能无法启用访问。final字段的修改也有额外限制,不能认为反射能任意修改所有字段。
反射有什么代价?
反射把部分检查推迟到了运行时,类名、方法名写错,或者参数不匹配,都可能到运行时才报错。它也增加了访问检查、动态调用等成本,具体性能取决于JDK版本和使用方式,不能简单说一定慢多少倍。
所以,反射适合框架、通用工具这些需要动态处理类型的场景,普通业务代码如果能直接调用,一般优先直接调用。频繁使用时,可以缓存Class、Method等信息,减少重复查找。
# 反射在你平时写代码或者框架中的应用场景有哪些?
加载数据库驱动
我们的项目底层数据库有时是用mysql,有时用oracle,需要动态地根据实际情况加载驱动类,这个时候反射就有用了,假设 com.mikechen.java.myqlConnection,com.mikechen.java.oracleConnection这两个类我们要用。
这时候我们在使用 JDBC 连接数据库时使用 Class.forName()通过反射加载数据库的驱动程序,如果是mysql则传入mysql的驱动类,而如果是oracle则传入的参数就变成另一个了。
//  DriverManager.registerDriver(new com.mysql.cj.jdbc.Driver());
Class.forName("com.mysql.cj.jdbc.Driver");
配置文件加载
Spring 框架的 IOC(动态加载管理 Bean),Spring通过配置文件配置各种各样的bean,你需要用到哪些bean就配哪些,spring容器就会根据你的需求去动态加载,你的程序就能健壮地运行。
Spring通过XML配置模式装载Bean的过程:
- 将程序中所有XML或properties配置文件加载入内存
- Java类里面解析xml或者properties里面的内容,得到对应实体类的字节码字符串以及相关的属性信息
- 使用反射机制,根据这个字符串获得某个类的Class实例
- 动态配置实例的属性
配置文件
className=com.example.reflectdemo.TestInvoke
methodName=printlnState
实体类
public class TestInvoke {
    private void printlnState(){
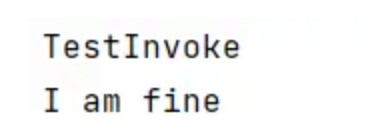
        System.out.println("I am fine");
    }
}
解析配置文件内容
// 解析xml或properties里面的内容,得到对应实体类的字节码字符串以及属性信息
public static String getName(String key) throws IOException {
    Properties properties = new Properties();
    FileInputStream in = new FileInputStream("D:/IdeaProjects/AllDemos/language-specification/src/main/resources/application.properties");
    properties.load(in);
    in.close();
    return properties.getProperty(key);
}
利用反射获取实体类的Class实例,创建实体类的实例对象,调用方法
public static void main(String[] args) throws NoSuchMethodException, InvocationTargetException, IllegalAccessException, IOException, ClassNotFoundException, InstantiationException {
    // 使用反射机制,根据这个字符串获得Class对象
    Class<?> c = Class.forName(getName("className"));
    System.out.println(c.getSimpleName());
    // 获取方法
    Method method = c.getDeclaredMethod(getName("methodName"));
    // 绕过安全检查
    method.setAccessible(true);
    // 创建实例对象(Class.newInstance() 已过时,使用 Constructor.newInstance())
    TestInvoke testInvoke = (TestInvoke) c.getDeclaredConstructor().newInstance();
    // 调用方法
    method.invoke(testInvoke);

}
运行结果:
# 注解
# 能讲一讲Java注解的原理吗?
注解本质是一个继承了Annotation的特殊接口,其具体实现类是Java运行时生成的动态代理类。
我们通过反射获取注解时,返回的是Java运行时生成的动态代理对象。通过代理对象调用自定义注解的方法,会最终调用AnnotationInvocationHandler的invoke方法。该方法会从memberValues这个Map中索引出对应的值。而memberValues的来源是Java常量池。
# 对注解解析的底层实现了解吗?
注解本质上是一种特殊的接口,它继承自 java.lang.annotation.Annotation 接口,所以注解也叫声明式接口,例如,定义一个简单的注解:
public @interface MyAnnotation {
    String value();
}
编译后,Java 编译器会将其转换为一个继承自 Annotation 的接口,并生成相应的字节码文件。
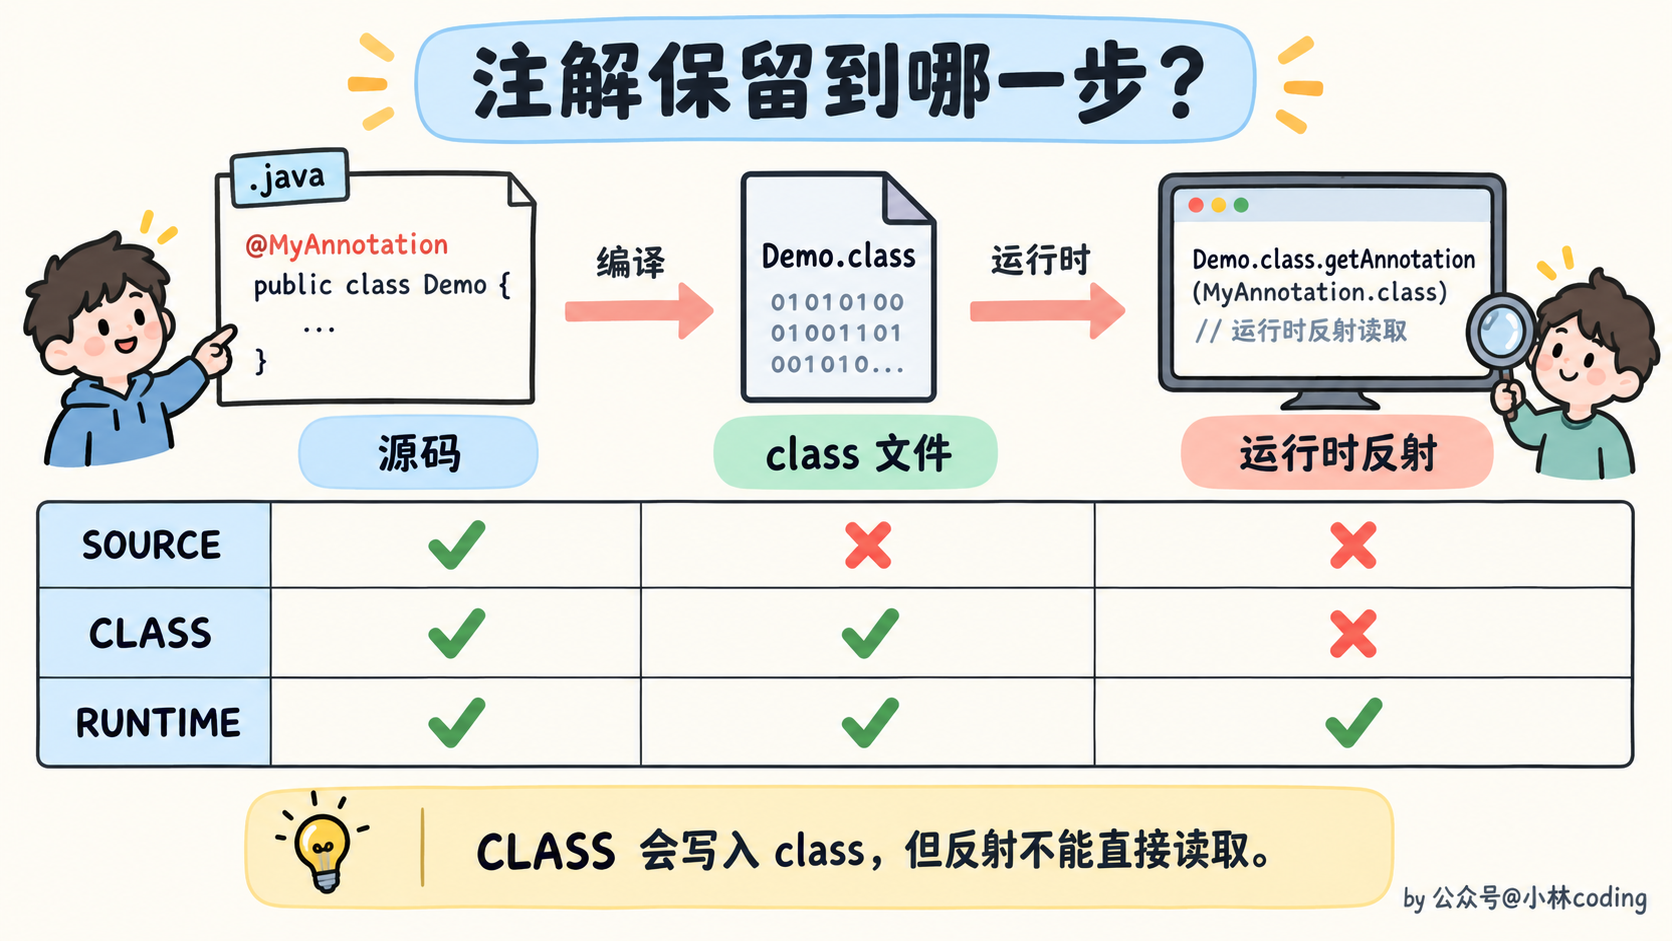
根据注解的作用范围,Java 注解可以分为以下几种类型:
- 源码级别注解 :仅存在于源码中,编译后不会保留(
@Retention(RetentionPolicy.SOURCE))。 - 类文件级别注解 :保留在
.class文件中,但运行时不可见(@Retention(RetentionPolicy.CLASS))。 - 运行时注解 :保留在
.class文件中,并且可以通过反射在运行时访问(@Retention(RetentionPolicy.RUNTIME))。
只有运行时注解可以通过反射机制进行解析。
当注解被标记为 RUNTIME 时,Java 编译器会在生成的 .class 文件中保存注解信息。这些信息存储在字节码的属性表(Attribute Table)中,具体包括以下内容:
- RuntimeVisibleAnnotations :存储运行时可见的注解信息。
- RuntimeInvisibleAnnotations :存储运行时不可见的注解信息。
- RuntimeVisibleParameterAnnotations 和 RuntimeInvisibleParameterAnnotations :存储方法参数上的注解信息。
通过工具(如 javap -v)可以查看 .class 文件中的注解信息。
注解的解析主要依赖于 Java 的反射机制。以下是解析注解的基本流程:
1、获取注册信息:通过反射 API 可以获取类、方法、字段等元素上的注解。例如:
Class<?> clazz = MyClass.class;
MyAnnotation annotation = clazz.getAnnotation(MyAnnotation.class);
if (annotation != null) {
    System.out.println(annotation.value());
}
2、底层原理:反射机制的核心类是 java.lang.reflect.AnnotatedElement,它是所有可以被注解修饰的元素(如 Class、Method、Field 等)的父接口。该接口提供了以下方法:
getAnnotation(Class<T> annotationClass):获取指定类型的注解。getAnnotations():获取所有注解。isAnnotationPresent(Class<? extends Annotation> annotationClass):判断是否包含指定注解。
这些方法本身由纯 Java 实现,并不是 native 方法。以 Class.getAnnotation(...) 为例,其内部会先触发注解数据的延迟解析:通过 AnnotationParser.parseAnnotations(...) 读取 JVM 在类加载阶段从 class 文件属性表(RuntimeVisibleAnnotations 等)中抽取并传回的原始字节,反序列化成 Map<Class<? extends Annotation>, Annotation>,最终以动态代理对象(AnnotationInvocationHandler)的形式返回给调用方。
JVM 在类加载阶段确实会解析 .class 文件中的注解信息,但这部分工作对应的 native 接口位于底层的常量池与属性表读取,而不是 getAnnotation 这一层 API。
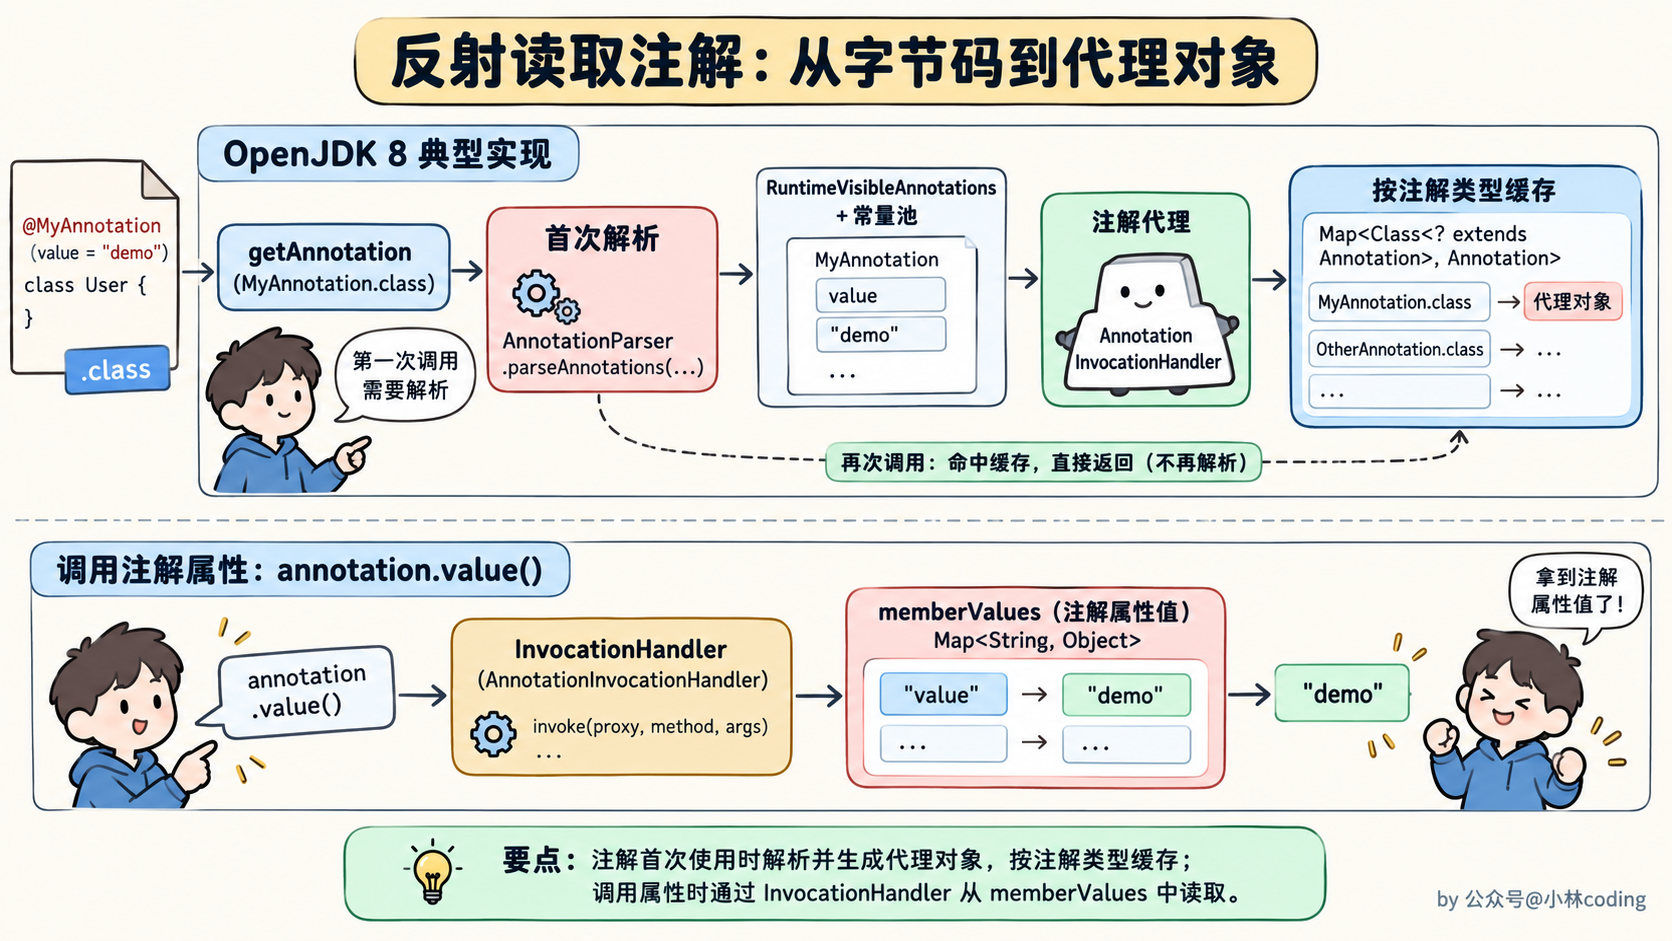
因此,注解解析的底层实现主要依赖于 Java 的反射机制和字节码文件的存储。通过 @Retention 元注解可以控制注解的保留策略,当使用 RetentionPolicy.RUNTIME 时,可以在运行时通过反射 API 来解析注解信息。在 JVM 层面,会从字节码文件中读取注解信息,并创建注解的代理对象来获取注解的属性值。
# Java注解的作用域呢?
注解的作用域(Scope)指的是注解可以应用在哪些程序元素上,由元注解 @Target 配合 ElementType 枚举来指定。在 Java 21 中,ElementType 共有 12 种取值:
TYPE:类、接口、枚举、注解类型FIELD:字段(包括枚举常量)METHOD:方法PARAMETER:方法或构造器的参数CONSTRUCTOR:构造方法LOCAL_VARIABLE:局部变量ANNOTATION_TYPE:注解类型本身(即元注解)PACKAGE:包(写在package-info.java中)TYPE_PARAMETER:类型参数声明(Java 8 新增,用于泛型形参上)TYPE_USE:任何使用类型的地方(Java 8 新增,常用于配合 Checker Framework 做类型检查)MODULE:模块(Java 9 模块系统引入)RECORD_COMPONENT:记录类组件(Java 16 引入 record 时新增)
其中最常用的是 TYPE、FIELD、METHOD、PARAMETER 这几种。如果定义注解时不显式指定 @Target,那么该注解默认可以用于上述除 TYPE_PARAMETER 和 TYPE_USE 之外的所有位置。
# 异常
# 介绍一下Java异常
Java异常类层次结构图:
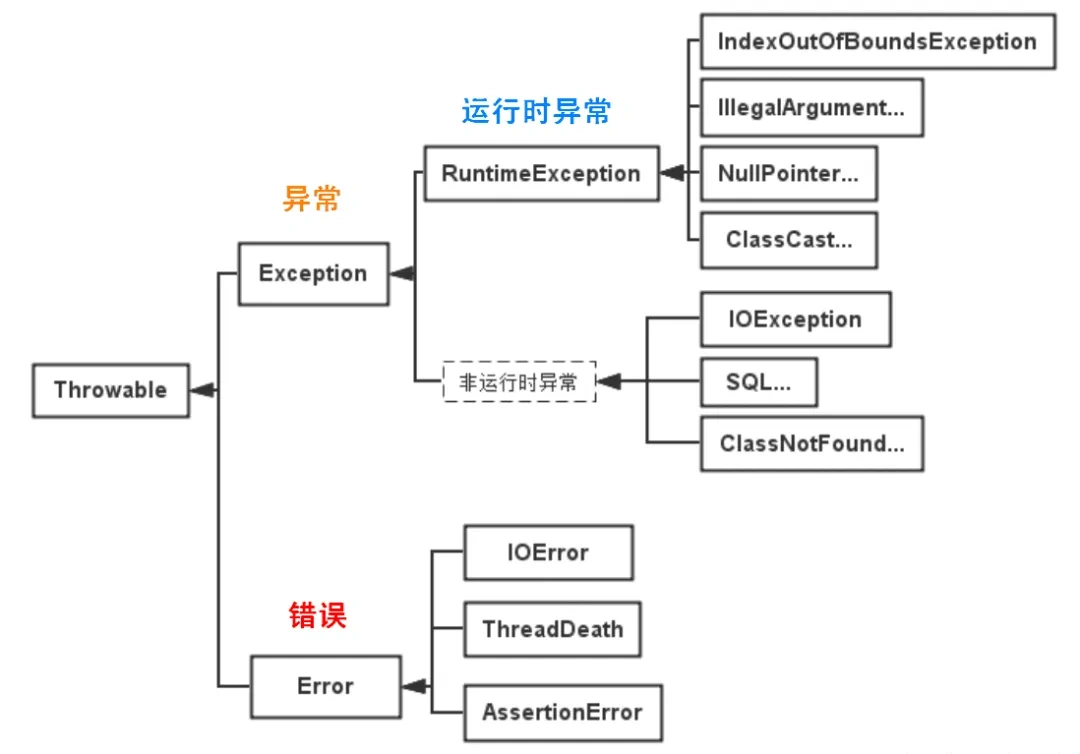
Java 的异常体系主要基于 Throwable 及其子类。Throwable 有两个重要的子类:Error 和 Exception,它们分别代表了不同类型的异常情况。
Error(错误): 表示运行环境的错误,错误是程序无法处理的严重问题,如虚拟机错误、动态链接库失效等。程序不应该尝试捕获这类错误。例如,OutOfMemoryError、StackOverflowError等。Exception(异常): 表示程序本身可以处理的异常情况。异常分为两大类:- 非运行时异常(受检异常,Checked Exception): 这类异常在编译时就必须被捕获或者声明抛出。它们通常是外部错误,如文件不存在 (
FileNotFoundException)、类未找到 (ClassNotFoundException) 等。非运行时异常强制程序员处理这些可能出现的问题,增强了程序的健壮性。 - 运行时异常(非受检异常,Unchecked Exception 或 RuntimeException): 这类异常特指
RuntimeException及其子类。它与Error一起构成了 Java 中的非受检异常家族。运行时异常由程序逻辑错误导致,如空指针访问 (NullPointerException)、数组越界 (ArrayIndexOutOfBoundsException) 等。运行时异常是不需要在编译时强制捕获或声明的。
- 非运行时异常(受检异常,Checked Exception): 这类异常在编译时就必须被捕获或者声明抛出。它们通常是外部错误,如文件不存在 (
# Java异常处理有哪些?
Java异常处理主要涉及try-catch、throw、throws、finally,以及try-with-resources。它们分别负责捕获异常、主动抛出异常、声明异常和释放资源。
try-catch:捕获并处理异常
try中放可能抛出异常的代码,catch匹配对应的异常类型。发生异常后,try中异常位置后面的代码不会继续执行,而是跳到匹配的catch。
try {
    int num = Integer.parseInt("abc");
    System.out.println(num); // 前面抛出异常,这里不会执行
} catch (NumberFormatException e) {
    System.out.println("输入的内容不是有效整数");
}
如果有多个catch,应该把具体的异常类型放在前面,范围大的放在后面,避免父类异常把子类异常提前接住。没有匹配的catch,异常就继续向调用方传播。
throw和throws:抛出与声明
throw用在方法体里,主动抛出一个异常对象;throws用在方法声明上,说明这个方法可能把哪些异常交给调用方。
public static void checkAge(int age) {
    if (age < 0) {
        throw new IllegalArgumentException("年龄不能为负数");
    }
}

public static String readFirstLine(String path) throws IOException {
    try (BufferedReader reader = new BufferedReader(new FileReader(path))) {
        return reader.readLine();
    }
}
像IOException这样的受检异常,要么在方法内部捕获,要么通过throws声明。RuntimeException和Error属于非受检异常,编译器不强制要求捕获或者声明。
finally:执行清理逻辑
正常进入try之后,不管是正常结束、抛出异常,还是执行return,通常都会执行finally。但不能说它在所有情况下都一定执行,比如JVM直接退出、进程被强制终止,或者代码一直没有离开try,finally就可能无法执行。
还要注意,不要在finally里写return,因为它可能覆盖try、catch中的返回值,甚至把原本应该传播的异常吞掉。
try-with-resources:自动关闭资源
对于文件流、数据库连接等实现了AutoCloseable接口的资源,可以使用try-with-resources。离开try时会自动调用close,比自己在finally里写关闭逻辑更方便。
try (BufferedReader reader = new BufferedReader(new FileReader("data.txt"))) {
    System.out.println(reader.readLine());
} catch (IOException e) {
    throw new IllegalStateException("读取文件失败", e);
}
如果声明了多个资源,会按声明的相反顺序关闭。如果try中的业务代码和close都抛出异常,业务异常会保留为主异常,关闭异常作为suppressed异常附加上去,可以通过getSuppressed查看。
实际开发中,异常处理还要避免空catch。能够处理就给出明确的恢复逻辑,不能处理就向上抛出,包装异常时保留原始cause,方便定位问题。
# 抛出异常为什么不用throws?
如果异常是未检查异常或者在方法内部被捕获和处理了,那么就不需要使用throws。
- Unchecked Exceptions:未检查异常(unchecked exceptions)是继承自RuntimeException类或Error类的异常,编译器不强制要求进行异常处理。因此,对于这些异常,不需要在方法签名中使用throws来声明。示例包括NullPointerException、ArrayIndexOutOfBoundsException等。
- 捕获和处理异常:另一种常见情况是,在方法内部捕获了可能抛出的异常,并在方法内部处理它们,而不是通过throws子句将它们传递到调用者。这种情况下,方法可以处理异常而无需在方法签名中使用throws。
# try catch中的语句运行情况
try块中的代码将按顺序执行,如果抛出异常,将在catch块中进行匹配和处理,然后程序将继续执行catch块之后的代码。如果没有匹配的catch块,异常将被传递给上一层调用的方法。
# try{return “a”} finally{return “b”}这条语句返回啥
finally块中的return语句会覆盖try块中的return返回,因此,该语句将返回"b"。
# object
# Object类有哪些方法?
Java Object 类是所有类的超类,默认提供 11 个核心方法,核心用于对象比较、哈希、字符串表示、线程同步等。
首先最常用的是 equals 方法,它的默认实现是比较两个对象的内存地址,也就是和 == 的效果一样,但实际开发中我们常需要按对象的内容比较,比如两个用户对象只要 id 相同就认为相等,这时候就需要重写 equals。比如:
class User {
    private int id;
    private String name;

    @Override
    public boolean equals(Object obj) {
        if (this == obj) return true;
        if (obj == null || getClass() != obj.getClass()) return false;
        User user = (User) obj;
        return id == user.id;
    }
}
和 equals 配套的必须重写 hashCode 方法,因为 Java 的约定是如果两个对象 equals 返回 true,它们的 hashCode 必须相等;如果 hashCode 不相等,equals 一定返回 false。如果只重写 equals 不重写 hashCode,会导致对象在 HashMap HashSet 等集合中无法正确存储,比如两个 id 相同的 User 对象,equals 返回 true,但 hashCode 不同,会被当成两个不同元素存入集合。重写示例:
@Override
public int hashCode() {
    return Integer.hashCode(id);
}
然后是 toString 方法,默认返回类名加 @加对象的哈希码十六进制表示,比如 User@1b6d3586,可读性很差。实际开发中重写它是为了返回对象的具体信息,方便日志打印和调试,比如:
@Override
public String toString() {
    return "User{id=" + id + ", name=" + name + "}";
}
接下来是 getClass 方法,它返回对象运行时的实际类对象,和编译时类型可能不同,而且这个方法不能重写。比如父类 Animal 的子类 Dog,Animal animal = new Dog,animal.getClass 返回的是 Dog 的类对象,常用于反射场景,比如通过 getClass 获取类的属性和方法:
Animal animal = new Dog();
Class<?> clazz = animal.getClass();
System.out.println(clazz.getName()); // 输出Dog
然后是 clone 方法,用于创建对象的浅拷贝,默认是浅拷贝意味着如果对象有引用类型属性,拷贝后的对象和原对象会共享该引用属性。使用 clone 需要让类实现 Cloneable 接口,否则会抛出 CloneNotSupportedException,比如:
class Product implements Cloneable {
    private String name;
    private double price;

    @Override
    protected Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}
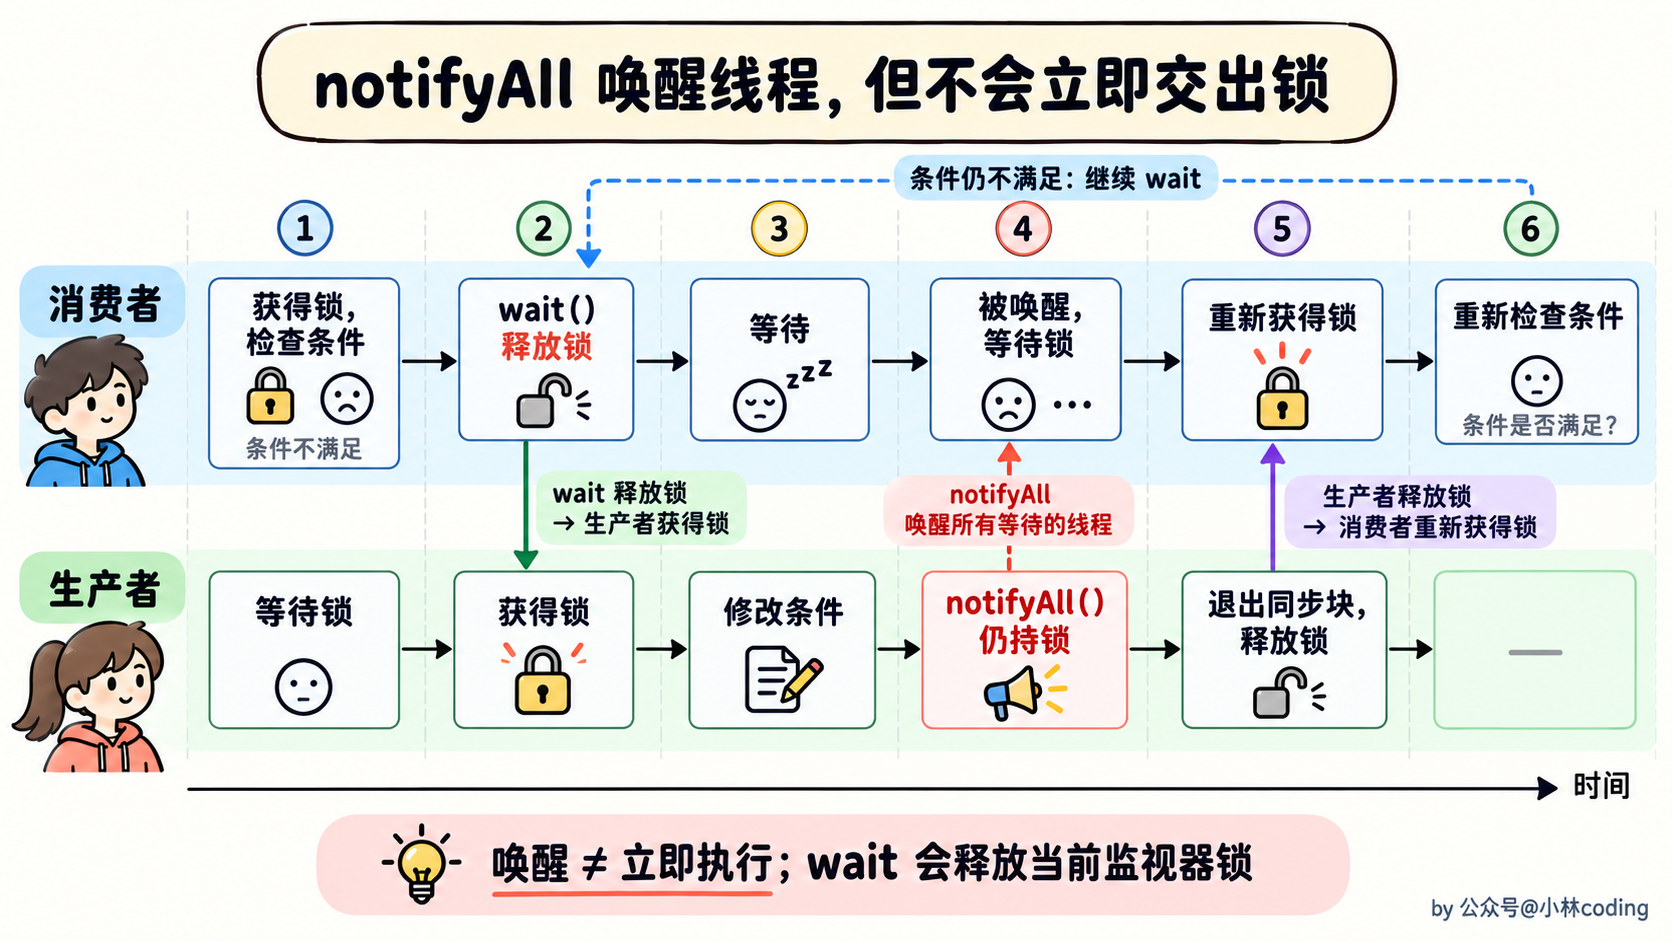
还有 notify 和 notifyAll 方法,它们都是用于多线程同步的,和 synchronized 配合使用,作用是唤醒等待当前对象锁的线程。notify 是随机唤醒一个等待线程,notifyAll 是唤醒所有等待线程,比如生产者消费者模式中,生产者生产完数据后调用 notifyAll,唤醒等待的消费者线程。
wait 方法有三个重载,作用是让当前持有对象锁的线程释放锁并进入等待状态,直到被 notify notifyAll 唤醒或者等待时间到期。同样需要在 synchronized 同步块或方法中使用,否则会抛 IllegalMonitorStateException,比如:
synchronized (lockObj) {
    while (条件不满足) {
        lockObj.wait(1000); // 等待1秒,超时自动唤醒
    }
    // 执行业务逻辑
}
最后是 finalize 方法,它是对象被垃圾回收器回收前会调用的方法,默认是空实现。但现在基本不推荐使用,因为它的执行时机不确定,可能很久才执行甚至不执行,而且可能导致对象复活,影响垃圾回收效率,Java9 之后已经标记为过时,替代方案是使用 try with resources 或者 PhantomReference 来处理资源释放。
# == 与 equals 有什么区别?
简单来说,== 比较的是"地址",而 equals 比较的是"内容"。但这句话如果不展开讲,其实很容易让人懵,我给你详细说一下。
先说 == 这个运算符。
== 在 Java 里其实是个非常简单粗暴的比较方式。如果你比较的是基本数据类型(比如 int、double),那它就直接比数值是不是相等,这个没啥问题。
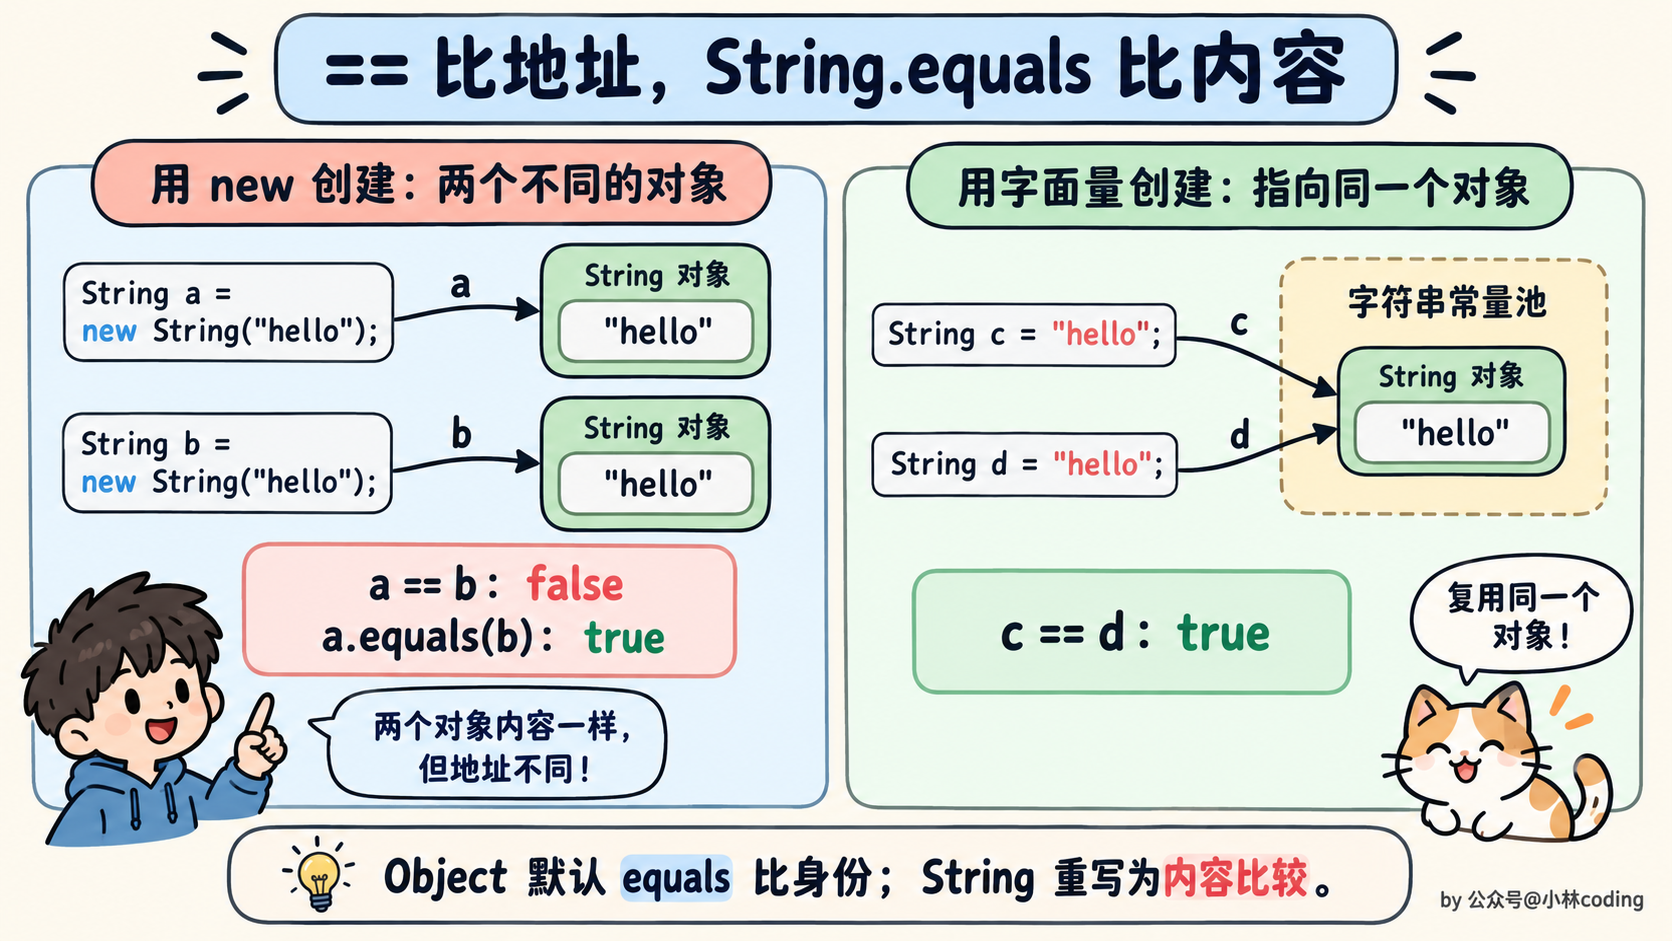
但如果你比较的是对象(引用类型),那 == 比较的就不是对象里面装的内容了,而是比较这两个变量是不是指向内存中同一个对象,也就是地址是否相同。
我举个例子你就明白了:
String a = new String("hello");
String b = new String("hello");

System.out.println(a == b);  // 输出 false
虽然 a 和 b 里面装的内容都是 "hello",但因为我用了两次 new,所以在堆内存里创建了两个完全独立的 String 对象。a 和 b 这两个变量分别指向了不同的对象,所以 == 一比较,发现地址不一样,就返回 false 了。
再说 equals 方法。
equals 是 Object 类里定义的一个方法,所有的 Java 对象都继承了它。它的默认行为其实和 == 一模一样,也是比地址。
但关键在于,很多常用的类(比如 String、Integer)都把这个方法给重写了。重写之后,equals 就不再比地址了,而是去比较对象里面实际存储的内容是否相等。
还是刚才那个例子:
String a = new String("hello");
String b = new String("hello");

System.out.println(a.equals(b));  // 输出 true
虽然 a 和 b 是两个不同的对象,但 String 类重写了 equals 方法,会逐个字符去比较内容。发现都是 "hello",所以返回 true。
这里有个经典的面试陷阱,就是字符串常量池的问题。
String c = "hello";
String d = "hello";

System.out.println(c == d);  // 输出 true
这里为什么 == 比较也是 true 呢?因为当你直接用双引号创建字符串的时候,JVM 会把它扔到一个叫"字符串常量池"的地方。如果池子里已经有了 "hello",那 d 就直接复用 c 指向的那个对象,所以它俩地址是一样的,== 自然就返回 true 了。
总结一下:
==是比较引用地址,适合用来判断两个变量是不是指向同一个对象;equals是比较对象内容,但前提是这个类重写了 equals 方法(比如 String),如果没重写,那它俩效果是一样的。
所以在实际开发中,如果我们要比较两个字符串或者对象的内容是否相等,一定要用 equals,而不是 ==。这也是为什么阿里巴巴开发规范里明确要求,判断字符串相等必须用 equals 的原因。
# hashcode和equals方法有什么关系?
**equals用来判断两个对象是否相等,hashCode用来帮助哈希集合快速定位对象。**它们的关系主要有以下几点:
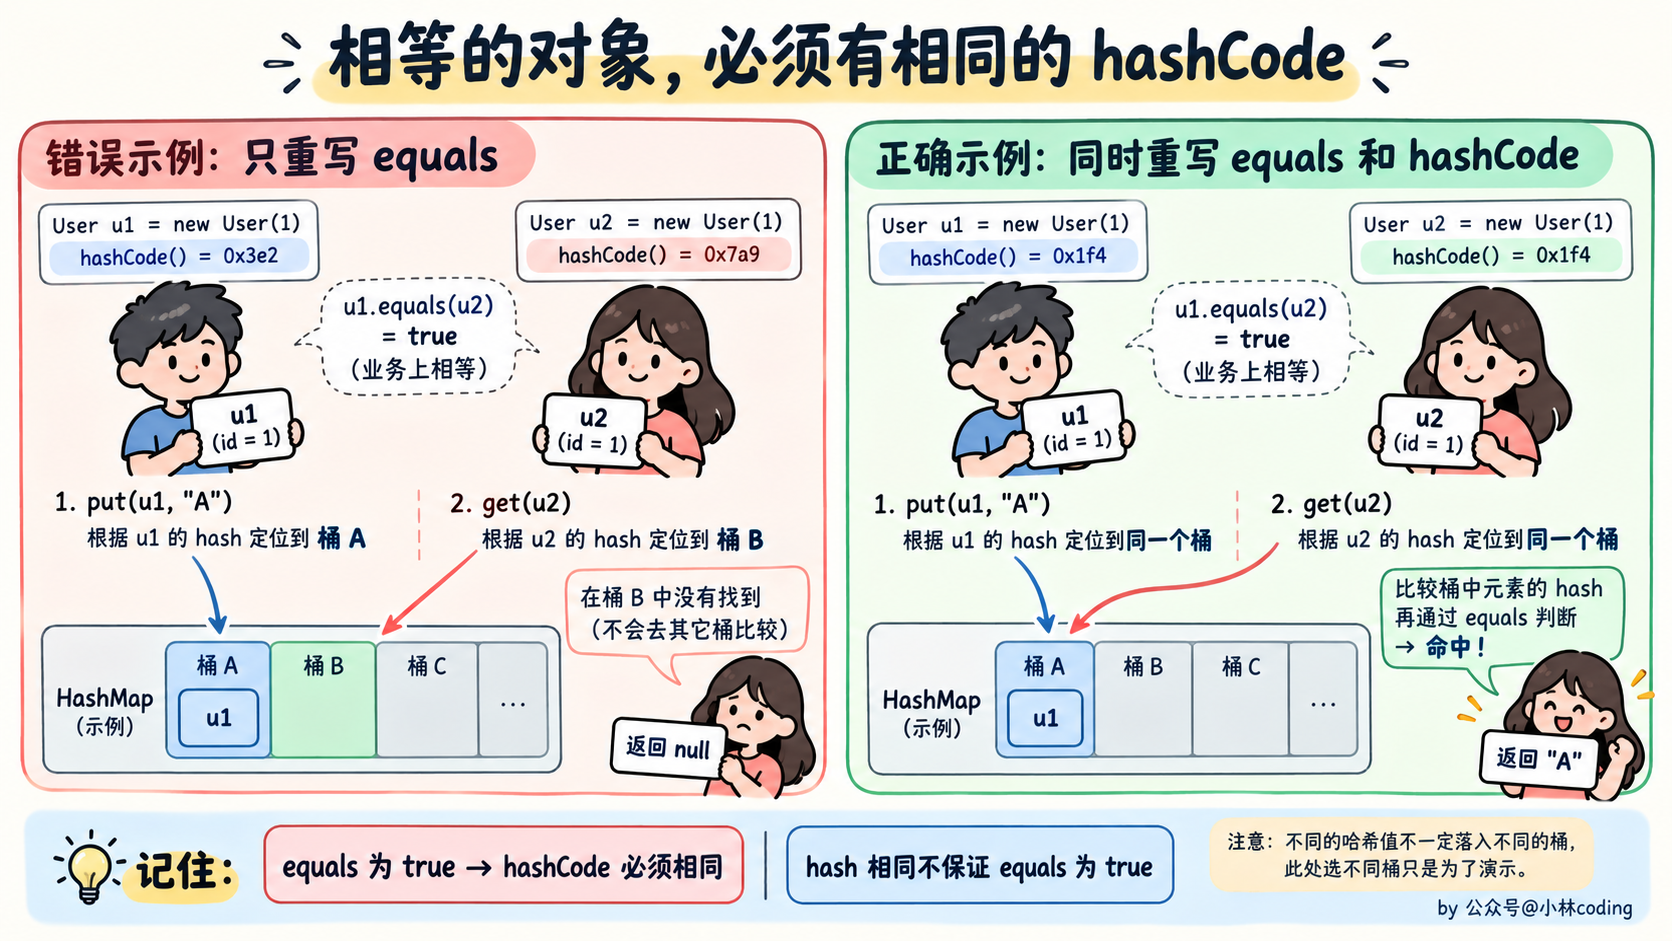
- 如果两个对象通过equals比较为true,那么它们的hashCode必须相同。
- 如果两个对象的hashCode相同,equals不一定为true,因为不同对象也可能发生哈希冲突。
- 如果参与equals比较的信息没有改变,那么同一个对象在一次程序运行期间,多次调用hashCode应该得到相同的结果。
为什么重写equals时,也要重写hashCode呢?这就要看HashMap、HashSet是怎么判断对象的了。
以HashMap为例,查找一个key时,它会先根据key的hashCode计算哈希值,再定位到对应的桶。找到桶之后,还要比较保存的哈希值,并通过==或者equals判断是不是要找的key。它不会把整个Map里的key都拿出来逐个调用equals。
所以,如果只重写equals,没有重写hashCode,两个业务上相等的对象就可能产生不同的哈希值,导致明明存过这个key,换一个相等的对象去查却查不到。
比如,我们认为两个User对象只要id相同,就是同一个用户,那么equals和hashCode都应该围绕id来实现:
final class User {
    private final int id;

    User(int id) {
        this.id = id;
    }

    @Override
    public boolean equals(Object obj) {
        if (this == obj) {
            return true;
        }
        if (obj == null || getClass() != obj.getClass()) {
            return false;
        }
        User other = (User) obj;
        return id == other.id;
    }

    @Override
    public int hashCode() {
        return Integer.hashCode(id);
    }
}
这样,即使是两个不同的User对象,也能作为同一个key来使用:
Map<User, String> map = new HashMap<>();
map.put(new User(1), "小林");

System.out.println(map.get(new User(1))); // 输出“小林”
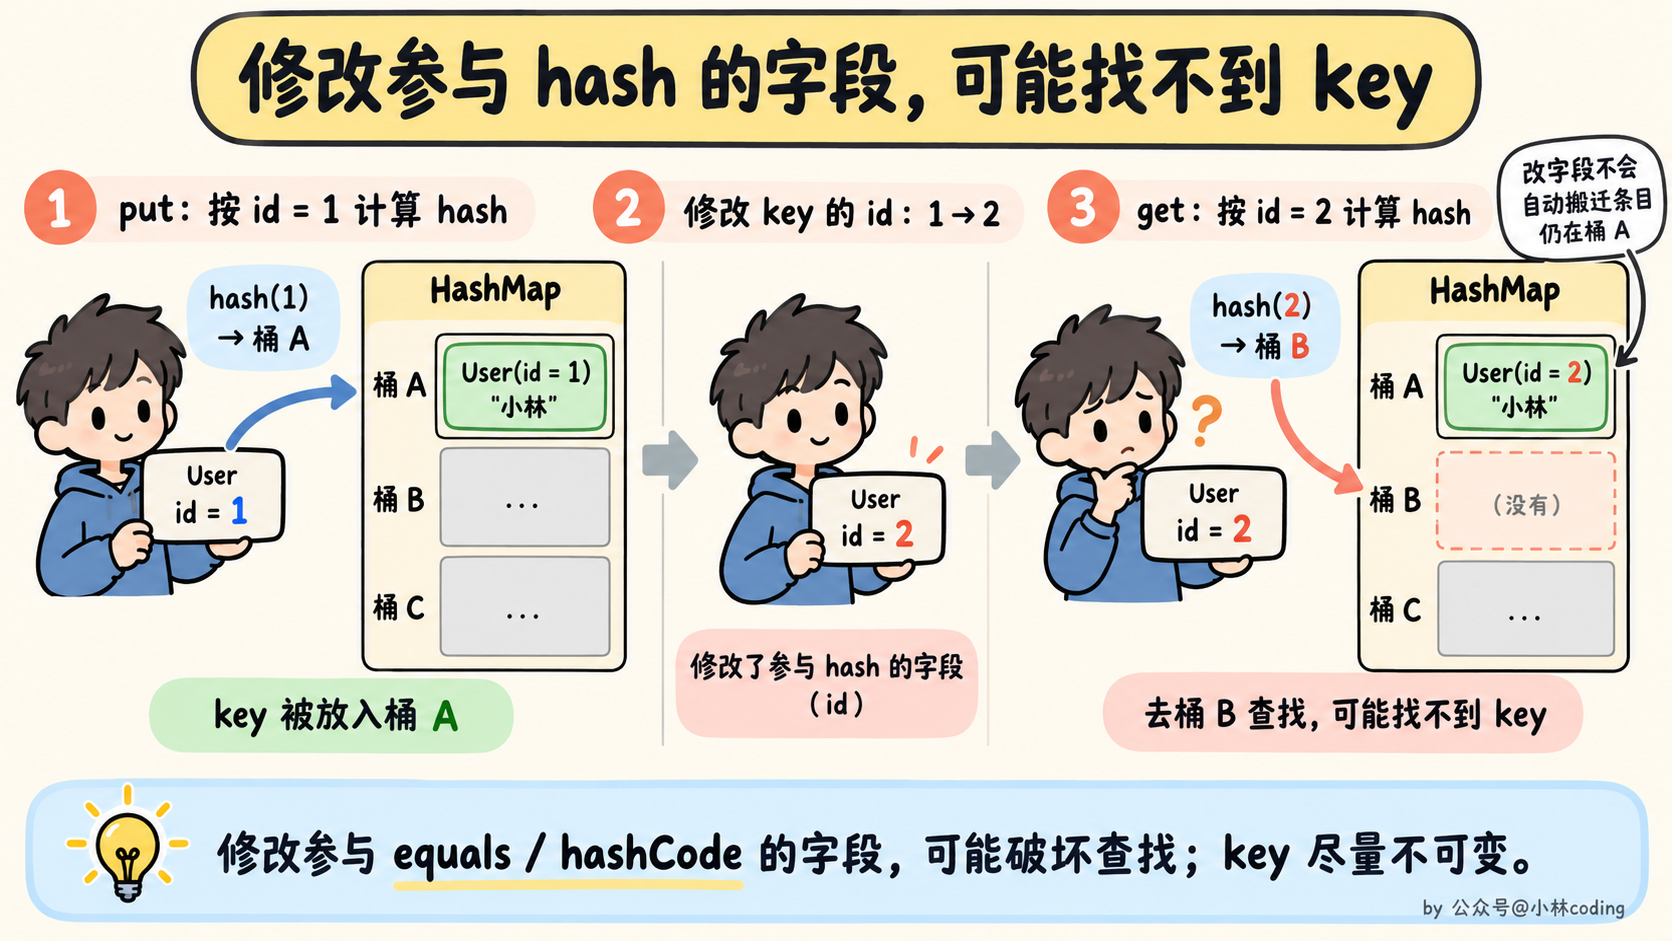
还有一个需要注意的地方:**对象作为HashMap的key之后,不要修改参与equals和hashCode计算的字段。**否则,存入时计算的哈希值和查找时计算的哈希值可能不一致,也会出现查不到的问题。上面的例子把id声明为final,就是为了避免这种情况。
# java 里 string的常用方法有哪些?
我常用的 String 常用方法有这些:
- 获取长度:
int length():返回字符串的长度(字符个数)。例:"abc".length()→ 3 - 判断内容:
boolean equals(Object obj):比较两个字符串的内容是否完全相同(区分大小写)。例:"abc".equals("ABC")→ false - 截取子串:
String substring(int beginIndex):从指定索引开始截取到末尾。例:"hello".substring(2)→ "llo" - 去除空格:
String trim():去除字符串首尾的空白字符(空格、制表符等)。例:" abc ".trim()→ "abc" - 替换内容:
String replace(char oldChar, char newChar):替换所有指定字符。例:"aaa".replace('a', 'b')→ "bbb" - 判断空字符串:
boolean isEmpty():判断字符串长度是否为 0(注意:null调用会报错,需先判空)。
# String、StringBuffer、StringBuilder的区别和联系
三者都可以用来处理字符串,主要区别在于内容是否可变、是否支持多线程共享,以及适合什么场景。
1、可变性:String是不可变的,创建后不能通过正常的String API修改它的内容。拼接、替换这些操作会返回结果字符串,原来的字符串不会被改掉。StringBuilder和StringBuffer是可变的,可以通过append、insert、delete等方法修改自身内容。
String str = "abc";
String old = str;
str = str + "def";

System.out.println(str); // abcdef
System.out.println(old); // abc,原对象的内容没有改变
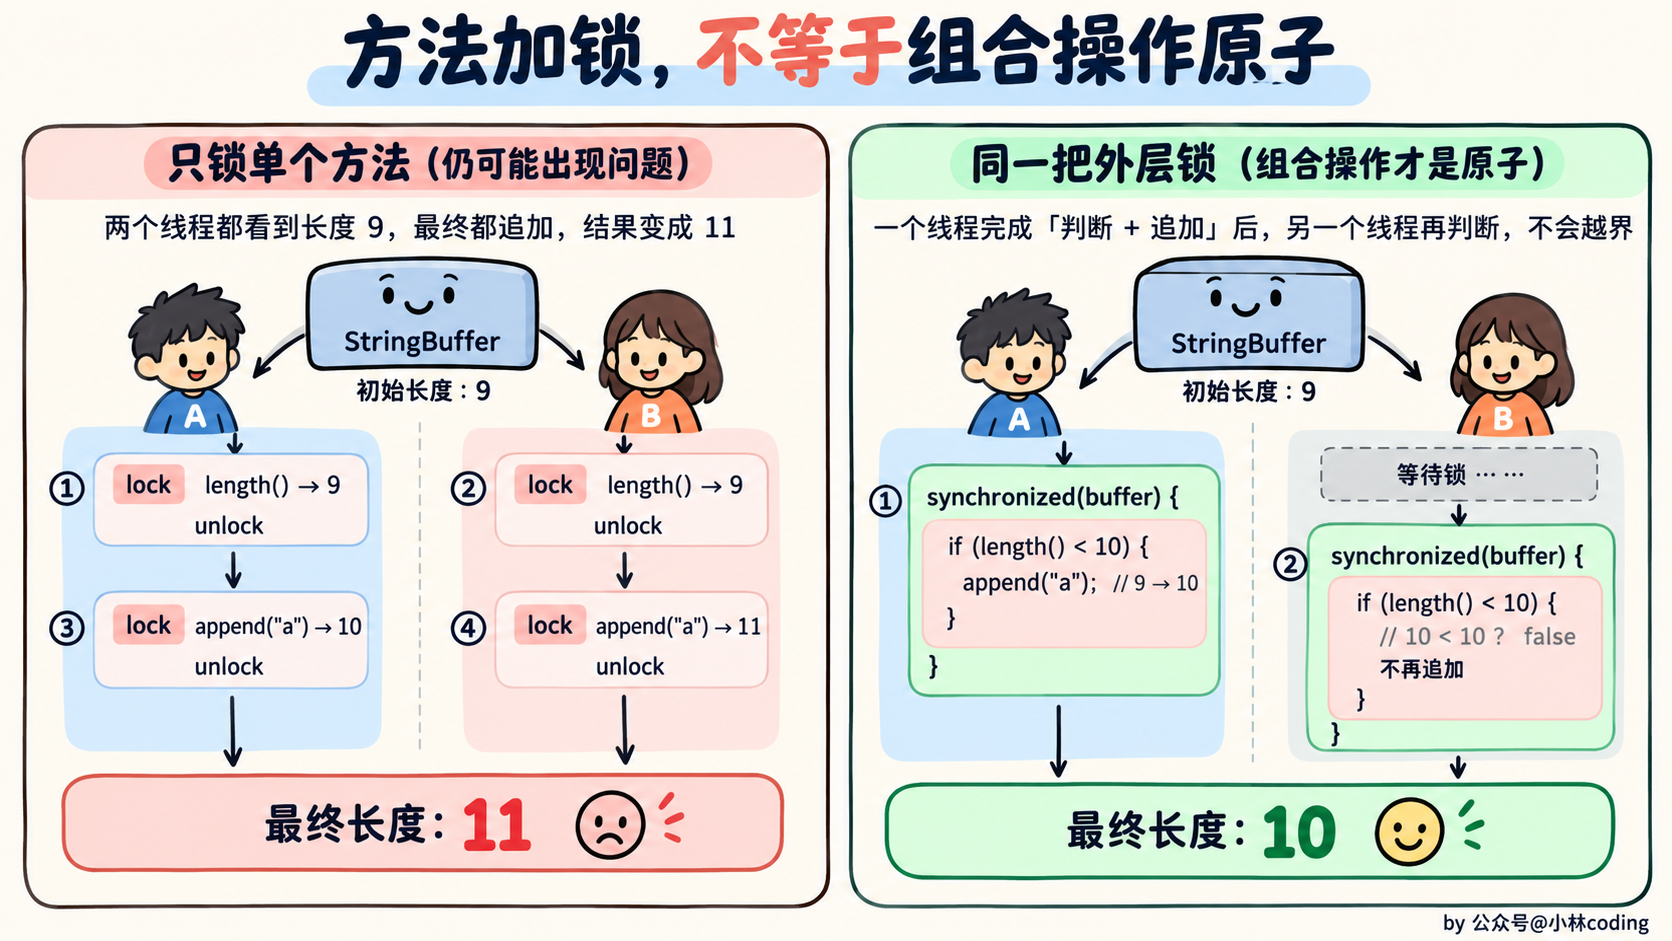
2、线程安全性:String的内容不可变,可以被多个线程安全地共享。StringBuilder没有提供同步保护,适合由一个线程独立使用。StringBuffer在需要同步的方法上使用了synchronized,可以支持多个线程对同一个实例进行操作。
不过,StringBuffer的方法线程安全,不代表多个方法组合起来的业务操作也一定线程安全。比如先判断长度,再追加内容,这两步之间仍然可能被其他线程插入操作,需要额外同步。假设buffer是多个线程共享的StringBuffer实例,可以把两步放在同一个同步块里:
synchronized (buffer) {
    if (buffer.length() < 10) {
        buffer.append("a");
    }
}
3、性能:不能简单地说String性能最低。对于固定内容、少量拼接,直接使用String通常就可以,编译器和JVM也会进行优化,比如"a" + "b"会在编译时合并为"ab"。
如果在循环里不断把内容拼接到同一个String变量上,会反复产生结果字符串、复制已有内容,这时候一般使用StringBuilder更合适:
StringBuilder builder = new StringBuilder();
for (int i = 0; i < 100; i++) {
    builder.append(i).append(",");
}
String result = builder.toString();
StringBuffer因为有同步开销,在不需要共享同一个实例的情况下,一般优先选择StringBuilder。另外,StringBuilder和StringBuffer追加内容时也可能触发内部缓冲区扩容,并不是整个操作过程完全不分配新内存。
4、使用场景:可以参考下面的对比:
| 特性 | String | StringBuilder | StringBuffer |
|---|---|---|---|
| 内容是否可变 | 不可变 | 可变 | 可变 |
| 线程安全性 | 内容可安全共享 | 不提供同步保护 | 方法提供同步保护,组合操作需另行判断 |
| 适用场景 | 字符串存储、传递和少量拼接 | 单个线程内频繁拼接 | 多线程共享同一个可变字符串实例 |
这里要注意,应用是多线程的,不代表就必须使用StringBuffer。比如Web请求中的局部StringBuilder,每个请求各用各的实例,没有共享,通常就不需要StringBuffer。
# Java 新特性
# Java 8 你知道有什么新特性?
下面是 Java 8 主要新特性的整理表格,包含关键改进和示例说明:
| 特性名称 | 描述 | 示例或说明 |
|---|---|---|
| Lambda 表达式 | 简化匿名内部类,支持函数式编程 | (a, b) -> a + b 代替匿名类实现接口 |
| 函数式接口 | 仅含一个抽象方法的接口,可用 @FunctionalInterface 注解标记 | Runnable, Comparator, 或自定义接口 @FunctionalInterface interface MyFunc { void run(); } |
| Stream API | 提供链式操作处理集合数据,支持并行处理 | list.stream().filter(x -> x > 0).collect(Collectors.toList()) |
| Optional 类 | 封装可能为 null 的对象,减少空指针异常 | Optional.ofNullable(value).orElse("default") |
| 方法引用 | 简化 Lambda 表达式,直接引用现有方法 | System.out::println 等价于 x -> System.out.println(x) |
| 接口的默认方法与静态方法 | 接口可定义默认实现和静态方法,增强扩展性 | interface A { default void print() { System.out.println("默认方法"); } } |
| 并行数组排序 | 使用多线程加速数组排序 | Arrays.parallelSort(array) |
| 重复注解 | 允许同一位置多次使用相同注解 | @Repeatable 注解配合容器注解使用 |
| 类型注解 | 注解可应用于更多位置(如泛型、异常等) | List<@NonNull String> list |
| CompletableFuture | 增强异步编程能力,支持链式调用和组合操作 | CompletableFuture.supplyAsync(() -> "result").thenAccept(System.out::println) |
# Lambda 表达式了解吗?
Lambda 表达式它是一种简洁的语法,用于创建匿名函数,主要用于简化函数式接口(只有一个抽象方法的接口)的使用。其基本语法有以下两种形式:
(parameters) -> expression:当 Lambda 体只有一个表达式时使用,表达式的结果会作为返回值。(parameters) -> { statements; }:当 Lambda 体包含多条语句时,需要使用大括号将语句括起来,若有返回值则需要使用return语句。
传统的匿名内部类实现方式代码较为冗长,而 Lambda 表达式可以用更简洁的语法实现相同的功能。比如,使用匿名内部类实现 Runnable 接口
public class AnonymousClassExample {
    public static void main(String[] args) {
        Thread t1 = new Thread(new Runnable() {
            @Override
            public void run() {
                System.out.println("Running using anonymous class");
            }
        });
        t1.start();
    }
}
使用 Lambda 表达式实现相同功能:
public class LambdaExample {
    public static void main(String[] args) {
        Thread t1 = new Thread(() -> System.out.println("Running using lambda expression"));
        t1.start();
    }
}
可以看到,Lambda 表达式的代码更加简洁明了。
还有,Lambda 表达式能够更清晰地表达代码的意图,尤其是在处理集合操作时,如过滤、映射等。比如,过滤出列表中所有偶数
import java.util.Arrays;
import java.util.List;
import java.util.stream.Collectors;

public class ReadabilityExample {
    public static void main(String[] args) {
        List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5, 6);
        // 使用 Lambda 表达式结合 Stream API 过滤偶数
        List<Integer> evenNumbers = numbers.stream()
                                           .filter(n -> n % 2 == 0)
                                           .collect(Collectors.toList());
        System.out.println(evenNumbers);
    }
}
通过 Lambda 表达式,代码的逻辑更加直观,易于理解。
还有,Lambda 表达式使得 Java 支持函数式编程范式,允许将函数作为参数传递,从而可以编写更灵活、可复用的代码。比如定义一个通用的计算函数。
interface Calculator {
    int calculate(int a, int b);
}

public class FunctionalProgrammingExample {
    public static int operate(int a, int b, Calculator calculator) {
        return calculator.calculate(a, b);
    }

    public static void main(String[] args) {
        // 使用 Lambda 表达式传递加法函数
        int sum = operate(3, 5, (x, y) -> x + y);
        System.out.println("Sum: " + sum);

        // 使用 Lambda 表达式传递乘法函数
        int product = operate(3, 5, (x, y) -> x * y);
        System.out.println("Product: " + product);
    }
}
虽然 Lambda 表达式优点蛮多的,不过也有一些缺点,比如会增加调试困难,因为 Lambda 表达式是匿名的,在调试时很难定位具体是哪个 Lambda 表达式出现了问题。尤其是当 Lambda 表达式嵌套使用或者比较复杂时,调试难度会进一步增加。
# Java中stream的API介绍一下
Java 8引入了Stream API,它提供了一种高效且易于使用的数据处理方式,特别适合集合对象的操作,如过滤、映射、排序等。Stream API不仅可以提高代码的可读性和简洁性,还能利用多核处理器的优势进行并行处理。让我们通过两个具体的例子来感受下Java Stream API带来的便利,对比在Stream API引入之前的传统做法。
案例1:过滤并收集满足条件的元素
问题场景:从一个列表中筛选出所有长度大于3的字符串,并收集到一个新的列表中。
没有Stream API的做法:
List<String> originalList = Arrays.asList("apple", "fig", "banana", "kiwi");
List<String> filteredList = new ArrayList<>();

for (String item : originalList) {
    if (item.length() > 3) {
        filteredList.add(item);
    }
}
这段代码需要显式地创建一个新的ArrayList,并通过循环遍历原列表,手动检查每个元素是否满足条件,然后添加到新列表中。
使用Stream API的做法:
List<String> originalList = Arrays.asList("apple", "fig", "banana", "kiwi");
List<String> filteredList = originalList.stream()
                                        .filter(s -> s.length() > 3)
                                        .collect(Collectors.toList());
这里,我们直接在原始列表上调用.stream()方法创建了一个流,使用.filter()中间操作筛选出长度大于3的字符串,最后使用.collect(Collectors.toList())终端操作将结果收集到一个新的列表中。代码更加简洁明了,逻辑一目了然。
案例2:计算列表中所有数字的总和
问题场景:计算一个数字列表中所有元素的总和。
没有Stream API的做法:
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5);
int sum = 0;
for (Integer number : numbers) {
    sum += number;
}
这个传统的for-each循环遍历列表中的每一个元素,累加它们的值来计算总和。
使用Stream API的做法:
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5);
int sum = numbers.stream()
                 .mapToInt(Integer::intValue)
                 .sum();
通过Stream API,我们可以先使用.mapToInt()将Integer流转换为IntStream(这是为了高效处理基本类型),然后直接调用.sum()方法来计算总和,极大地简化了代码。
# Stream流的并行API是什么?
是 ParallelStream。
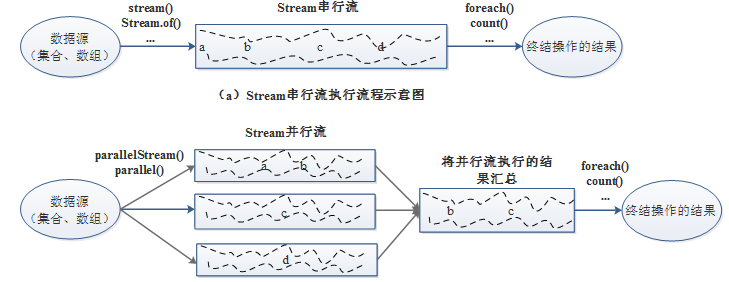
并行流(ParallelStream)就是将源数据分为多个子流对象进行多线程操作,然后将处理的结果再汇总为一个流对象,底层是使用通用的 fork/join 池来实现,即将一个任务拆分成多个“小任务”并行计算,再把多个“小任务”的结果合并成总的计算结果
Stream串行流与并行流的主要区别:
对CPU密集型的任务来说,并行流使用ForkJoinPool线程池,为每个CPU分配一个任务,这是非常有效率的,但是如果任务不是CPU密集的,而是I/O密集的,并且任务数相对线程数比较大,那么直接用ParallelStream并不是很好的选择。
# completableFuture怎么用的?
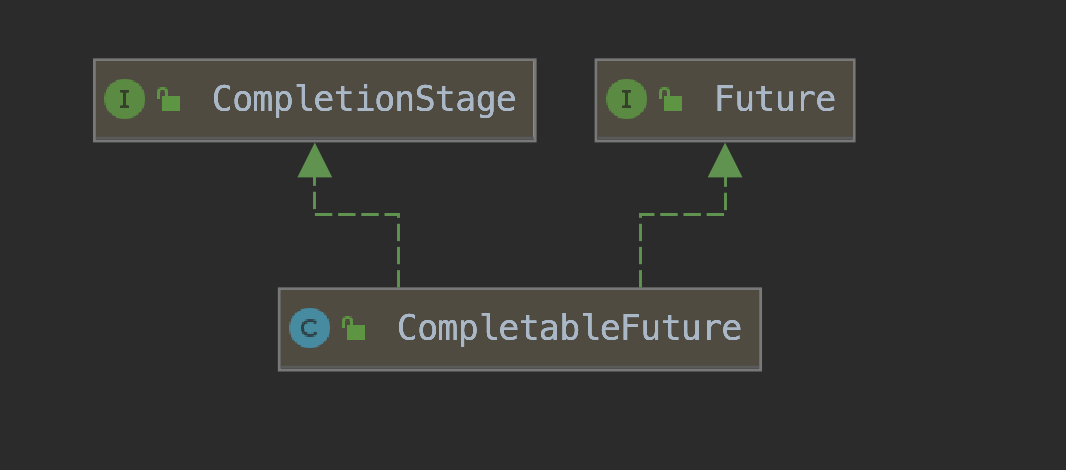
CompletableFuture是Java 8引入的异步编程工具,实现了Future和CompletionStage接口。它不仅能表示一个异步任务的结果,还能把多个异步任务按依赖关系组合起来。
普通Future通常需要通过get等待结果,再继续处理;CompletableFuture可以直接注册后续操作,任务完成后再触发下一步,减少手动等待和嵌套回调。
创建异步任务
runAsync:执行没有返回值的任务。supplyAsync:执行有返回值的任务。
两者都可以传入自定义Executor。实际项目里,可以根据任务类型配置线程池,避免所有任务都挤到默认的公共线程池中。
处理和组合结果
常用方法主要有这些:
| 方法 | 作用 |
|---|---|
| thenApply | 根据上一步结果进行转换,返回新结果 |
| thenAccept | 消费上一步结果,不返回业务结果 |
| thenRun | 执行后续操作,不使用上一步的结果 |
| thenCompose | 上一步完成后启动一个依赖它的异步任务,把结果展平 |
| thenCombine | 两个任务都正常完成后,合并它们的结果 |
| allOf | 等待所有任务完成,返回CompletableFuture<Void>,不直接收集结果 |
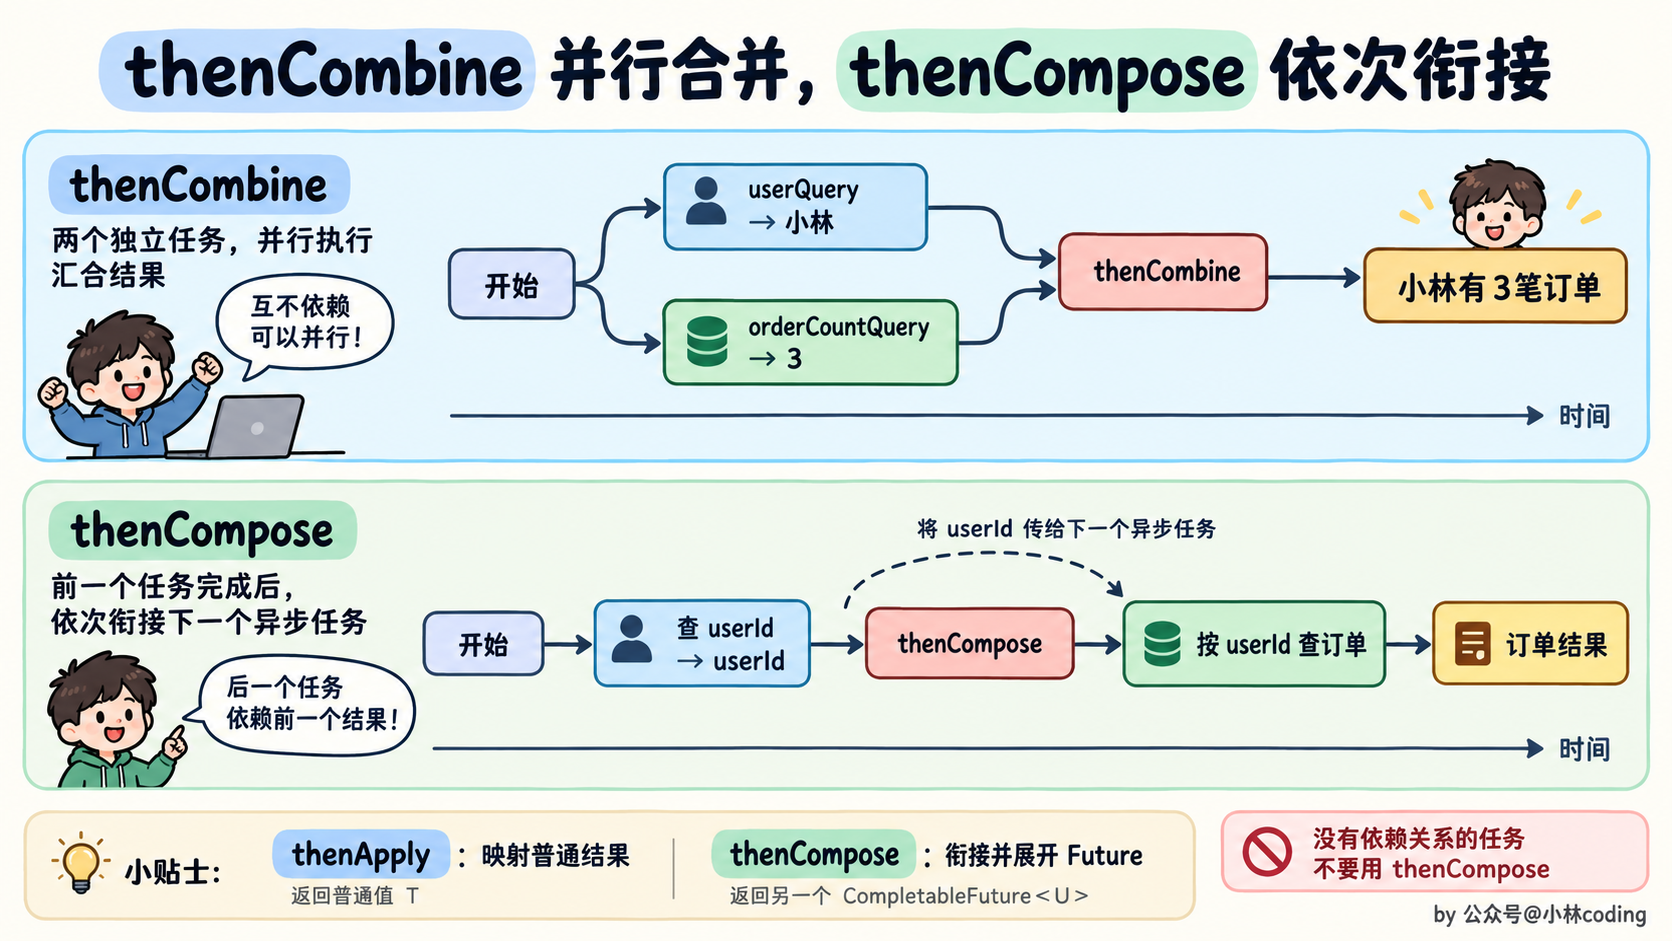
比如,查询用户信息和查询订单数量互不依赖,可以同时执行,等两者完成后再拼成一个结果:
ExecutorService executor = Executors.newFixedThreadPool(4);
try {
    CompletableFuture<String> userFuture = CompletableFuture.supplyAsync(() -> {
        // 模拟查询用户信息
        return "小林";
    }, executor);

    CompletableFuture<Integer> orderFuture = CompletableFuture.supplyAsync(() -> {
        // 模拟查询订单数量
        return 3;
    }, executor);

    CompletableFuture<String> resultFuture = userFuture
        .thenCombine(orderFuture, (user, count) -> user + "有" + count + "笔订单")
        .exceptionally(ex -> "查询失败,请稍后重试");

    System.out.println(resultFuture.join()); // 小林有3笔订单
} finally {
    executor.shutdown();
}
这里两个查询没有依赖关系,所以用thenCombine。如果需要先查询用户ID,再根据ID异步查询订单,就更适合用thenCompose。
thenApply和thenCompose的区别,主要看后续操作返回什么:返回普通值,使用thenApply;返回另一个CompletableFuture,通常使用thenCompose,避免结果变成CompletableFuture<CompletableFuture<T>>。
异常怎么处理?
exceptionally:上游异常时提供一个替代结果。handle:不管成功还是异常,都会处理,并返回一个新结果。whenComplete:观察结果或异常,常用于日志和清理;通常保留原来的结果或异常,不用于返回替代值,回调自身抛出异常也可能影响后续阶段。
上面的exceptionally是简化的降级示例,实际项目里还要记录异常,并区分哪些异常可以降级,不能把所有错误都静默转换成默认值。
后续操作在哪个线程执行?
不带Async的方法,比如thenApply,可能由完成上游任务的线程执行;如果注册时上游已经完成,也可能由注册回调的线程执行。注册回调不代表一定会切换线程。
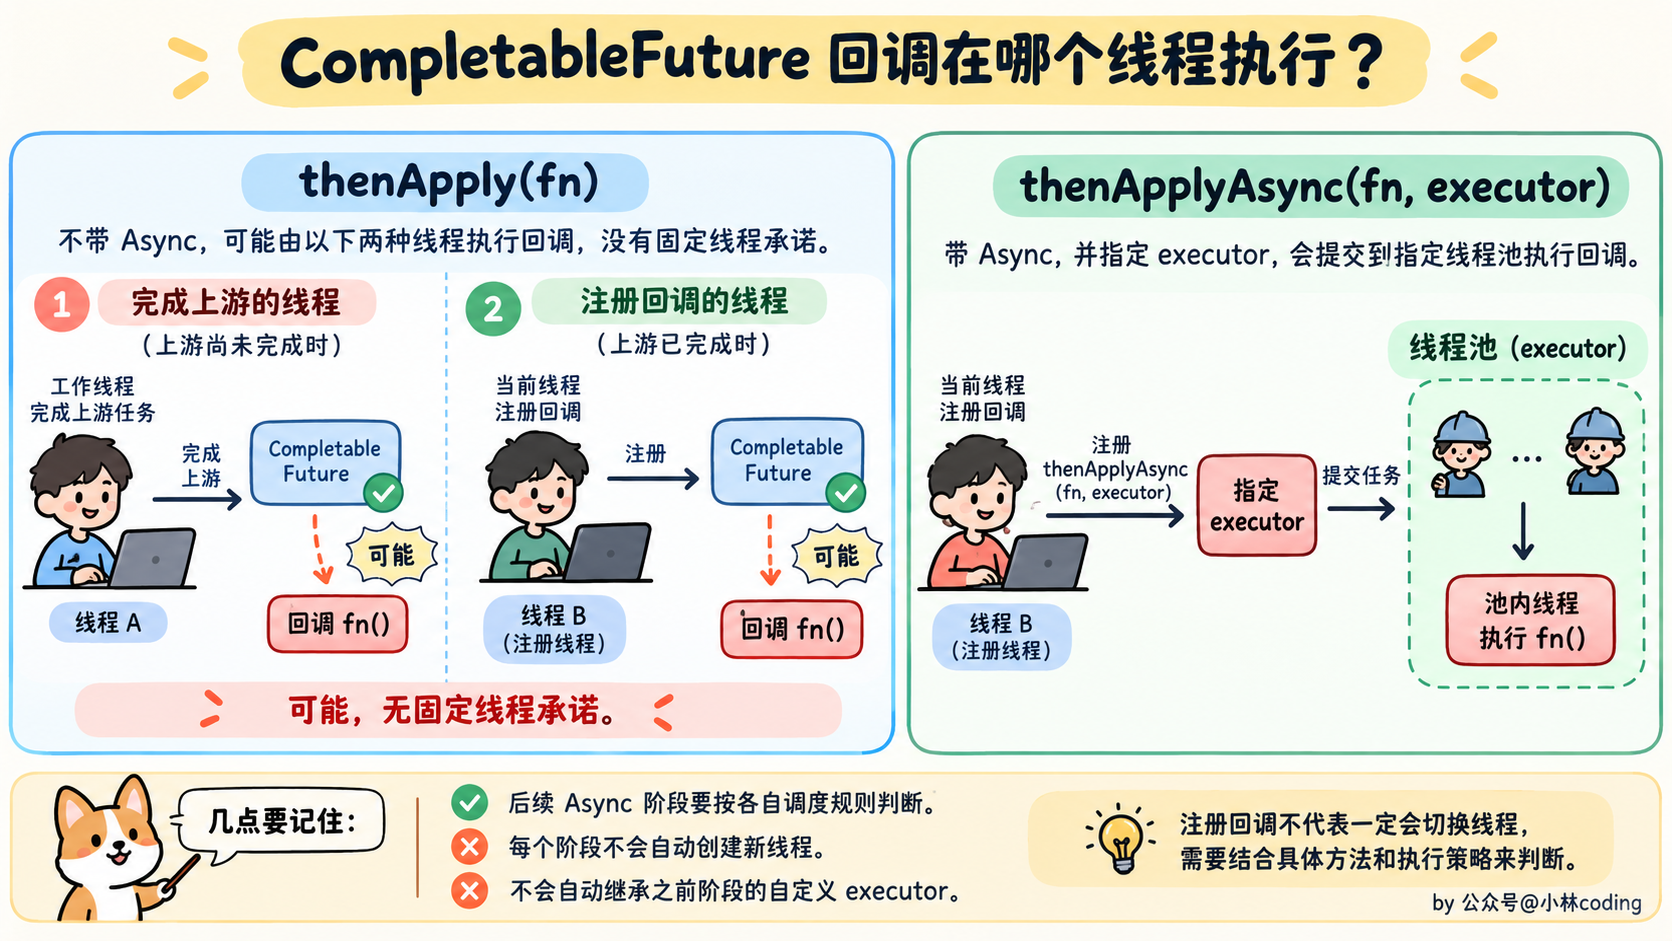
带Async的方法可以通过Executor指定执行线程池。对于直接创建的CompletableFuture,不指定Executor时,默认通常使用ForkJoinPool.commonPool;公共池并行度不足时还有其他执行策略。因此,耗时的阻塞IO任务一般使用单独配置的线程池,并明确传给相应的异步阶段。
最后,get和join都会在结果没有完成时等待。get需要处理InterruptedException、ExecutionException等受检异常,join主要通过CompletionException传播任务异常。异步编排时应尽量先组合任务,在确实需要结果的边界再等待,避免每启动一个任务就立刻get,变成串行执行。
# Java 21 新特性知道哪些?
新语言特性:
- Switch 语句的模式匹配(JEP 441):它允许在
switch的case标签中使用模式匹配,使操作更加灵活和类型安全,减少了样板代码和潜在错误。例如,对于不同类型的账户类,可以在switch语句中直接根据账户类型的模式来获取相应的余额,如case SavingsAccount sa -> result = sa.getSavings(); - 记录模式(Record Patterns,JEP 440):将模式匹配扩展到记录类(record),允许在
instanceof或switch中直接对 record 进行解构。例如:if (obj instanceof Point(int x, int y)) { ... },可以直接把Point记录的组件解构到x、y变量中。 - 字符串模板(预览版,JEP 430):提供了一种更可读、更易维护的方式来构建复杂字符串,支持在字符串字面量中直接嵌入表达式。需要通过模板处理器(如
STR)调用,嵌入表达式使用\{...}语法。例如,以前可能需要使用"hello " + name + ", welcome!"这样的方式拼接字符串,Java 21 中可以写成STR."hello \{name}, welcome!"。注意:该特性在 JDK 23 中已被撤回以待重新设计。
新并发特性方面:
- 虚拟线程:这是 Java 21 引入的一种轻量级并发的新选择。它的栈在堆上动态分配,运行时挂载到平台载体线程(carrier thread)上执行,挂起时栈被卸载到堆中,因此可以创建大量虚拟线程而不消耗大量内存,显著提升了 I/O 密集型应用的吞吐量和响应速度。可以使用静态构建方法、构建器或
ExecutorService来创建和使用虚拟线程。 - Scoped Values(范围值):提供了一种在线程间共享不可变数据的新方式,避免使用传统的线程局部存储,促进了更好的封装性和线程安全,可用于在不通过方法参数传递的情况下,传递上下文信息,如用户会话或配置设置。
# 序列化
# 怎么把一个对象从一个jvm转移到另一个jvm?
- 使用序列化和反序列化:将对象序列化为字节流,并将其发送到另一个 JVM,然后在另一个 JVM 中反序列化字节流恢复对象。这可以通过 Java 的 ObjectOutputStream 和 ObjectInputStream 来实现。
- 使用消息传递机制:利用消息传递机制,比如使用消息队列(如 RabbitMQ、Kafka)或者通过网络套接字进行通信,将对象从一个 JVM 发送到另一个。这需要自定义协议来序列化对象并在另一个 JVM 中反序列化。
- 使用远程方法调用(RPC):可以使用远程方法调用框架,如 gRPC,来实现对象在不同 JVM 之间的传输。远程方法调用可以让你在分布式系统中调用远程 JVM 上的对象的方法。
- 使用共享数据库或缓存:将对象存储在共享数据库(如 MySQL、PostgreSQL)或共享缓存(如 Redis)中,让不同的 JVM 可以访问这些共享数据。这种方法适用于需要共享数据但不需要直接传输对象的场景。
# 序列化和反序列化让你自己实现你会怎么做?
如果让我自己实现,我会先定义一套对象和字节流之间的转换协议,再分别实现编码器和解码器。核心不是简单地把字段拼起来,而是让接收方知道每一段数据是什么、怎么还原,以及版本变化后怎么兼容。
先确定支持哪些数据
第一版可以先支持基本类型、字符串、列表和简单对象,把支持范围说清楚。比如要传一个User对象,里面有id、name,就要约定这两个字段如何编码。
整数需要约定占用字节数和字节序;字符串需要约定字符编码,比如UTF-8,以及长度表示的是编码后的字节数。null和空字符串也要能区分。
定义字节流格式
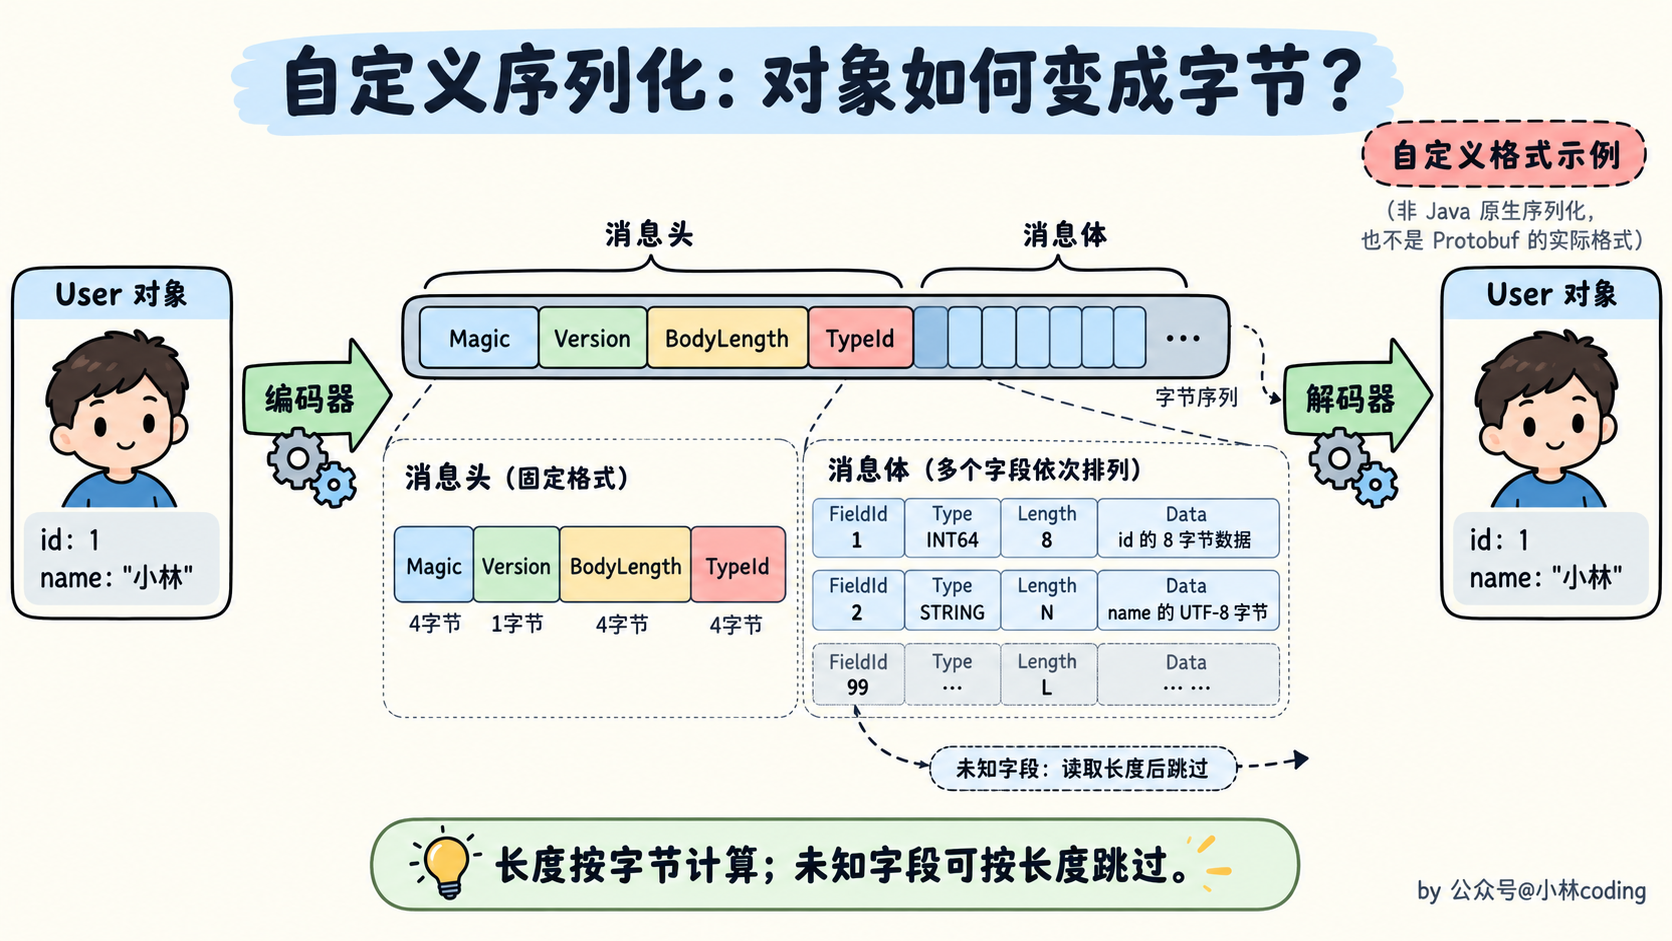
我会把消息分成消息头和消息体。消息头保存魔数、协议版本、消息体长度和类型标识;消息体按字段组织,比如采用“字段编号、字段类型、数据长度、字段数据”的格式。
消息头:魔数 | 协议版本 | 消息体长度 | 类型标识
消息体:字段编号 | 字段类型 | 数据长度 | 字段数据
比如User的id用字段编号1,name用字段编号2。字段编号固定后,即使以后调整代码里的字段顺序,解码时也可以根据编号找到对应的字段。
实现序列化和反序列化
序列化时,读取对象的字段,把数值按约定格式写入字节流;字符串先转成UTF-8字节,再写入长度和内容。可以用DataOutputStream写入基本类型数据,也可以用ByteBuffer组织字节。
反序列化时,先检查消息头,再逐个读取字段,根据类型和编号解析数据,最后创建对象并填充字段。简单对象可以手写编码器,通用场景可以借助反射或者代码生成,但两边必须遵循同一套协议。
如果数据通过TCP发送,还需要按消息长度识别边界,处理一次只收到部分消息,或者一次收到多条消息的情况,不能认为一次read就对应一个完整对象。
处理版本兼容
新增字段时使用新的编号,旧版本遇到不认识的字段,可以根据长度跳过;新版本读取旧数据时,对缺失字段使用约定的默认值。已经删除的字段编号不要复用,已有字段的类型也不能随意修改。
循环引用和重复引用也需要单独设计。比如A引用B、B又引用A,直接递归编码会停不下来。如果要支持这种对象图,就需要给对象分配编号,后续写入引用编号;如果第一版不支持,就要检测后明确报错。
做好输入检查
反序列化时需要限制消息大小、字符串长度、集合大小和嵌套深度,检查长度是否合法、数据是否完整,避免畸形数据导致越界或者大量内存分配。类型标识也应该映射到允许的类型,不能根据输入里的任意类名加载和创建对象。
所以,面试里我会从格式设计、编码解码、版本兼容、对象引用和输入校验这几个方面回答。实际项目中,如果没有特殊要求,一般优先选择成熟方案,比如跨语言的结构化数据可以考虑Protobuf,调试和可读性优先时可以考虑JSON,再根据需求评估体积和性能。
# 将对象转为二进制字节流具体怎么实现?
其实,像序列化和反序列化,无论这些可逆操作是什么机制,都会有对应的处理和解析协议,例如加密和解密,TCP的粘包和拆包,序列化机制是通过序列化协议来进行处理的,和 class 文件类似,它其实是定义了序列化后的字节流格式,然后对此格式进行操作,生成符合格式的字节流或者将字节流解析成对象。
在Java中通过序列化对象流来完成序列化和反序列化:
- ObjectOutputStream:通过writeObject()方法做序列化操作。
- ObjectInputStrean:通过readObject()方法做反序列化操作。
只有实现了Serializable或Externalizable接口的类的对象才能被序列化,否则抛出异常!
实现对象序列化:
- 让类实现Serializable接口:
import java.io.Serializable;

public class MyClass implements Serializable {
    // class code
}
- 创建输出流并写入对象:
import java.io.FileOutputStream;
import java.io.ObjectOutputStream;

MyClass obj = new MyClass();
try {
    FileOutputStream fileOut = new FileOutputStream("object.ser");
    ObjectOutputStream out = new ObjectOutputStream(fileOut);
    out.writeObject(obj);
    out.close();
    fileOut.close();
} catch (IOException e) {
    e.printStackTrace();
}
实现对象反序列化:
- 创建输入流并读取对象:
import java.io.FileInputStream;
import java.io.ObjectInputStream;

MyClass newObj = null;
try {
    FileInputStream fileIn = new FileInputStream("object.ser");
    ObjectInputStream in = new ObjectInputStream(fileIn);
    newObj = (MyClass) in.readObject();
    in.close();
    fileIn.close();
} catch (IOException | ClassNotFoundException e) {
    e.printStackTrace();
}
通过以上步骤,对象 obj 会被序列化并写入到文件 "object.ser" 中,然后通过反序列化操作,从文件中读取字节流并恢复为对象 newObj。这种方式可以方便地将对象转换为字节流用于持久化存储、网络传输等操作。需要注意的是,要确保类实现了 Serializable 接口,并且所有需要序列化的(即非 static、非 transient)成员变量都是 Serializable 的才能被正确序列化;被 transient 或 static 修饰的字段不会参与默认序列化。
# 设计模式
# volatile和sychronized如何实现单例模式
public class SingleTon {

    // volatile 关键字修饰变量 防止指令重排序
    private static volatile SingleTon instance = null;
    private SingleTon(){}

    public static  SingleTon getInstance(){
        if(instance == null){
            //同步代码块 只有在第一次获取对象的时候会执行到 ,第二次及以后访问时 instance变量均非null故不会往下执行了 直接返回啦
            synchronized(SingleTon.class){
                if(instance == null){
                    instance = new SingleTon();
                }
            }
        }
        return instance;
    }
}
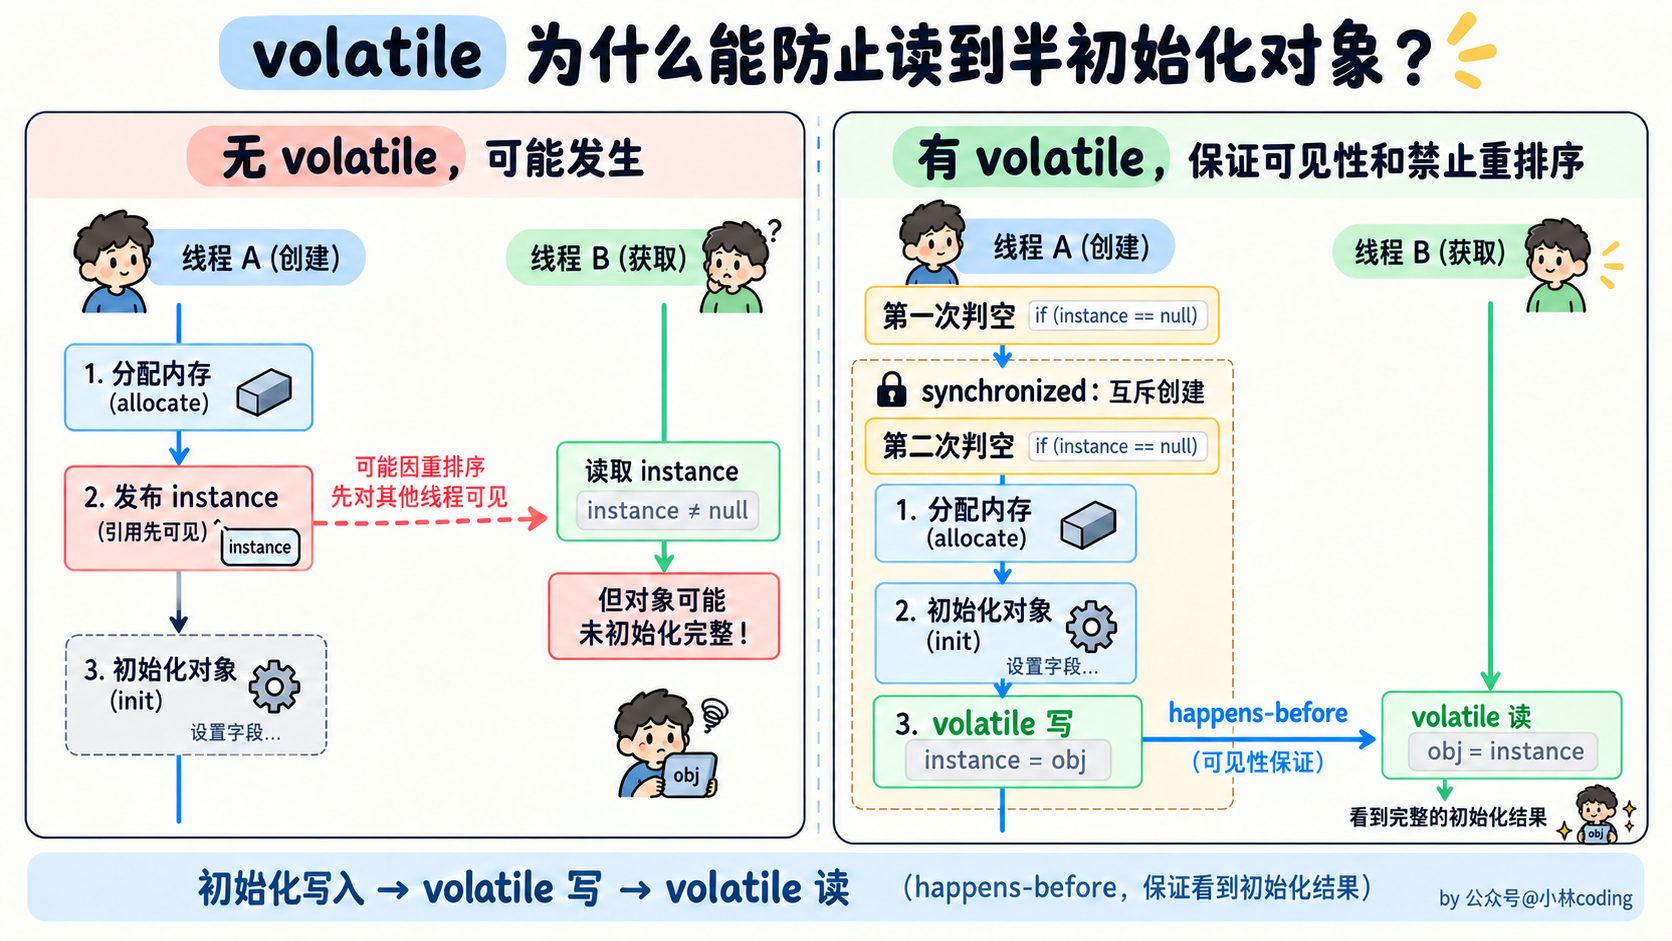
正确的双重检查锁定模式需要使用 volatile。volatile主要包含两个功能。
- 保证可见性。使用 volatile 定义的变量,将会保证对所有线程的可见性。
- 禁止指令重排序优化。
由于 volatile 禁止对象创建时指令之间重排序,所以其他线程不会访问到一个未初始化的对象,从而保证安全性。
# 代理模式和适配器模式有什么区别?
- 目的不同:代理模式主要关注控制对对象的访问,而适配器模式则用于接口转换,使不兼容的类能够一起工作。
- 结构不同:代理模式一般包含抽象主题、真实主题和代理三个角色,适配器模式包含目标接口、适配器和被适配者三个角色。
- 应用场景不同:代理模式常用于添加额外功能或控制对对象的访问,适配器模式常用于让不兼容的接口协同工作。
# 责任链模式使用场景是什么?
责任链模式的使用场景核心很明确,就是一个请求需要多个独立的处理逻辑来承接,同时不想让请求发起方和所有处理者产生强关联,还得让处理流程能灵活调整,简单说就是谁能处理就谁来接手,整个处理顺序和参与节点能按需改动。
比如实际开发里最常遇到的接口请求校验,用户调用我们的接口时,可能得先检查登录状态,再验证 token 是否有效,接着确认接口访问权限,最后还要限制请求频率,这些校验逻辑各自独立,而且不同接口需要的校验步骤不一样,比如登录接口只需要验证验证码,查询用户信息的接口得同时过登录和权限校验。要是不用责任链,就得在每个接口里写一堆 if-else 把这些校验串起来,后续想改某个校验规则,所有相关接口都得动,维护起来特别麻烦。
这时候用责任链就很合适,我们可以把每个校验逻辑封装成一个处理节点,先定义一个抽象的处理者类:
// 抽象处理者
abstract class Handler {
    protected Handler next;
    // 设置下一个处理节点
    public void setNext(Handler next) {
        this.next = next;
    }
    // 抽象处理方法
    public abstract boolean handle(Request request);
}
然后每个校验逻辑都继承这个类,比如登录校验:
// 登录态校验节点
class LoginHandler extends Handler {
    @Override
    public boolean handle(Request request) {
        if (request.isLogin()) {
            System.out.println("登录态校验通过,交给下一个节点");
            // 校验通过,交给下一个处理者
            return next != null ? next.handle(request) : true;
        } else {
            System.out.println("未登录,直接返回失败");
            // 校验不通过,终止链路
            return false;
        }
    }
}
再写个权限校验节点、频率限制节点,最后在使用的时候,根据接口需求动态组装链路:
// 组装链路:登录校验 -> 权限校验 -> 频率限制
Handler loginHandler = new LoginHandler();
Handler authHandler = new AuthHandler();
Handler rateLimitHandler = new RateLimitHandler();
loginHandler.setNext(authHandler);
authHandler.setNext(rateLimitHandler);

// 发起请求
Request request = new Request(true, "admin", 1); // 已登录、管理员权限、第1次请求
boolean result = loginHandler.handle(request);
这样一来,请求发起方只需要调用第一个节点,根本不用关心后面有多少校验步骤,也不用知道具体是哪个节点在处理;如果某个接口不需要频率限制,直接去掉 rateLimitHandler 的组装就行,不用修改任何校验节点的代码,流程调整起来特别灵活。
# 介绍一下策略模式和责任链模式,分别用在哪些场景?
这两个设计模式都属于行为型模式,而且在实际开发中,它们往往都是为了解决同一个痛点:如何消除代码中复杂的 **if-else** 或 **switch-case** 逻辑,从而让系统更易于扩展。
策略模式
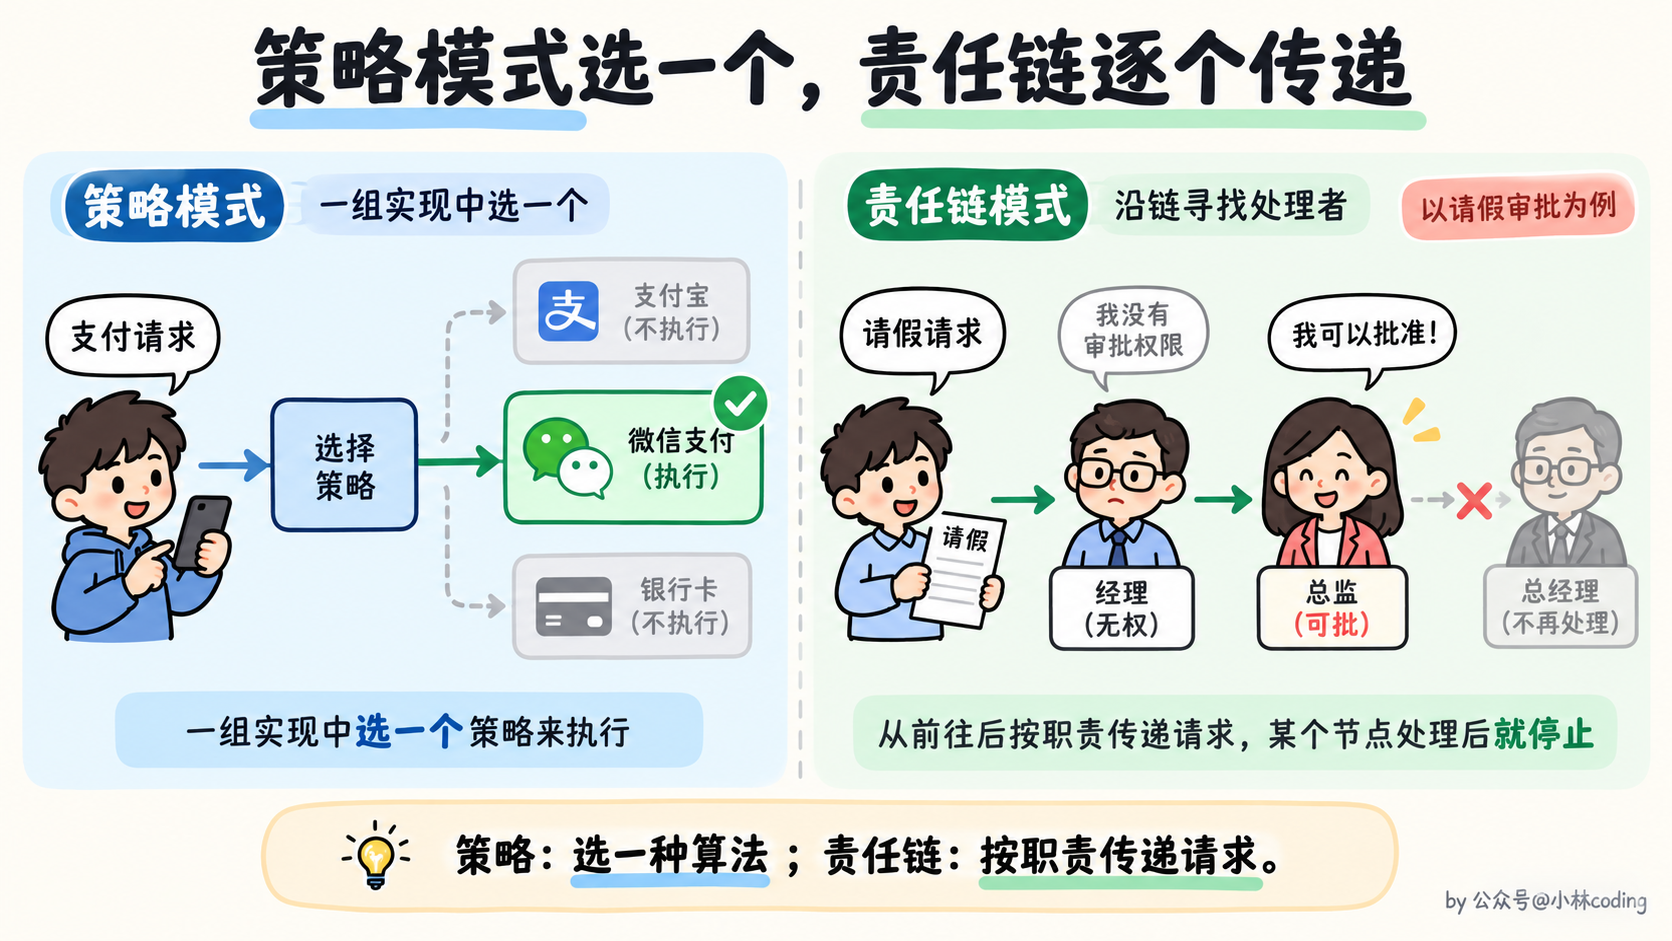
策略模式定义一系列算法,把它们一个个封装起来,并且使它们可相互替换。从而让算法可独立于使用它的客户而变化。
假设你正在开发一个电商网站的支付模块。用户可以选择支付宝、微信支付或者银行卡支付。每种支付方式的底层逻辑(比如调用的 API、加密方式、参数构造)都完全不同,但对于调用支付功能的上层业务逻辑来说,它只需要调用一个统一的 “支付” 方法即可,无需关心具体是哪种支付。
这就是策略模式的用武之地。我们把每种支付方式(支付宝、微信)都封装成一个独立的 “策略” 类,它们都遵循一个共同的接口。上层业务代码通过这个共同的接口来调用支付功能,并可以在运行时根据用户的选择,动态地切换不同的策略。
所以,策略模式适用场景如下:
- 当一个系统需要动态地在几种算法中选择一种时。
- 当一个对象有很多行为,不想使用大量的
if-else或switch-case语句来选择时。 - 当你希望算法的变化不会影响到使用它的客户端时。
责任链模式
责任链模式核心思想是为请求创建一个接收者对象的链。对请求的发送者和接收者进行解耦,让多个对象都有机会处理这个请求。请求沿着链传递,直到链上的一个对象处理它为止。
想象一下公司里的请假审批流程。一个员工要请假,他首先会把请假条交给自己的直属经理。如果请假天数很短(比如 1 天),经理自己就能批准。如果天数较长(比如 5 天),经理没有权限,就需要把请假条上报给部门总监。总监也有自己的审批权限上限,如果超过了,就需要继续上报给总经理。
在这个过程中,请假条(请求)就在一条由经理 -> 总监 -> 总经理(接收者链)上传递,直到某个角色(接收者)能够处理它。发送请假条的员工(客户端)并不知道最终是谁批准了他的假,他只需要把请求提交给链的第一个节点(经理)即可。
所以,责任链模式适用场景总结:
- 当有多个对象可以处理同一个请求,但具体由哪个对象处理需要在运行时决定时。
- 当你希望请求的发送者和接收者解耦,不直接通信时。
- 当你需要动态地指定和修改处理一个请求的对象集合时。
# I/O
# Java怎么实现网络IO高并发编程?
可以用 Java NIO ,是一种同步非阻塞的I/O模型,也是I/O多路复用的基础。
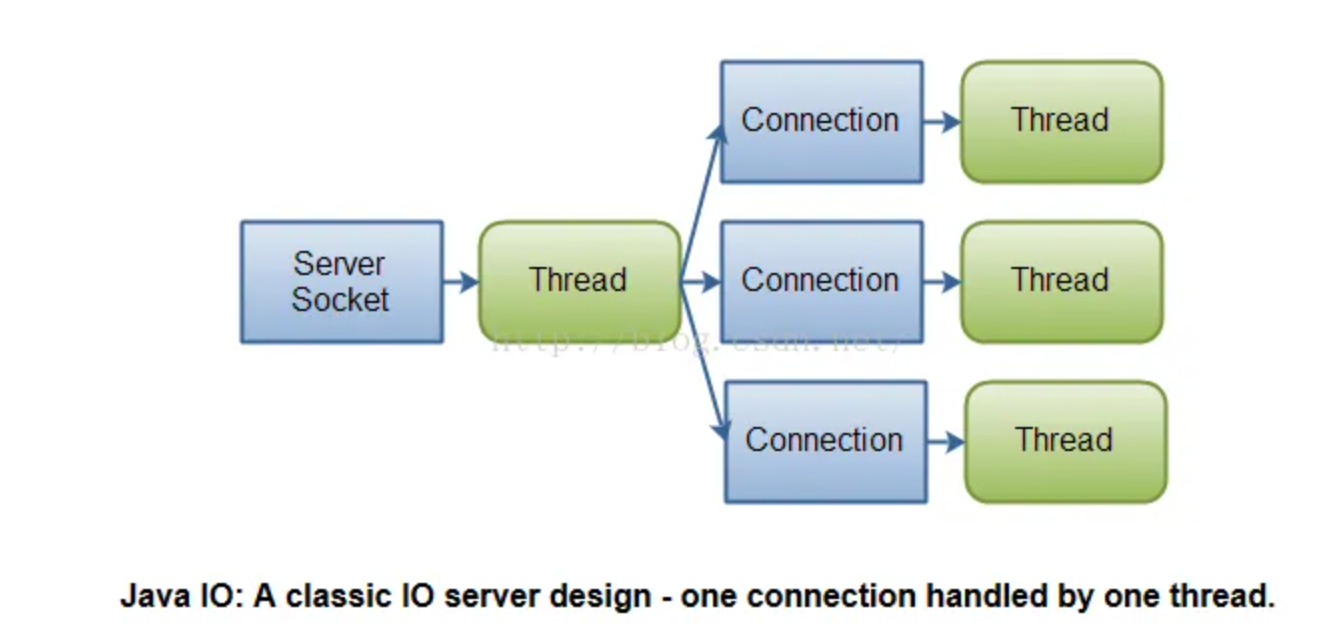
传统的BIO里面socket.read(),如果TCP RecvBuffer里没有数据,函数会一直阻塞,直到收到数据,返回读到的数据, 如果使用BIO要想要并发处理多个客户端的i/o,那么会使用多线程模式,一个线程专门处理一个客户端 io,这种模式随着客户端越来越多,所需要创建的线程也越来越多,会急剧消耗系统的性能。
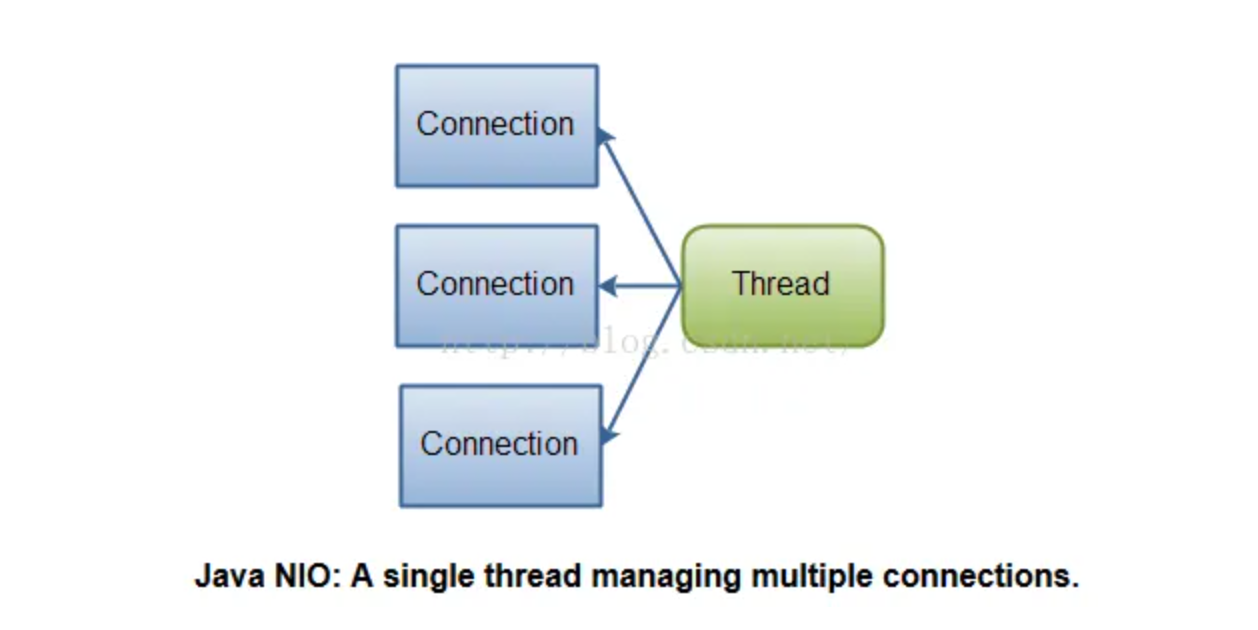
NIO 是基于I/O多路复用实现的,它可以只用一个线程处理多个客户端I/O,如果你需要同时管理成千上万的连接,但是每个连接只发送少量数据,例如一个聊天服务器,用NIO实现会更好一些。
# BIO、NIO、AIO区别是什么?
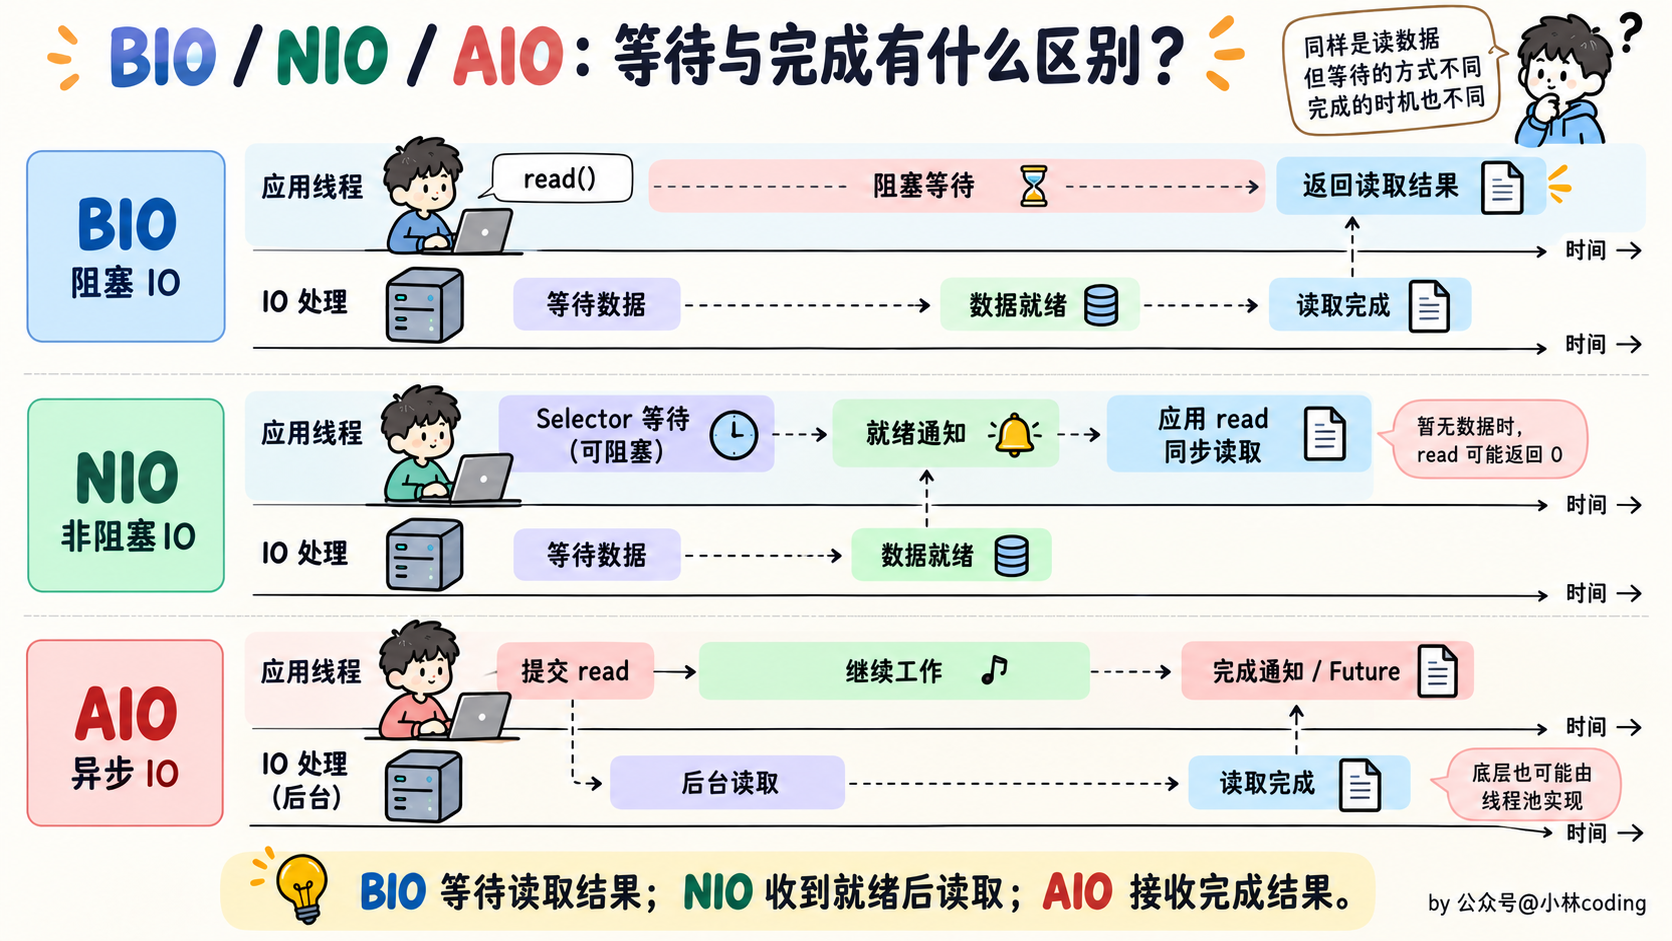
- BIO(blocking IO):就是传统的 java.io 包,它是基于流模型实现的,交互的方式是同步、阻塞方式,也就是说在读入输入流或者输出流时,在读写动作完成之前,线程会一直阻塞在那里,它们之间的调用是可靠的线性顺序。优点是代码比较简单、直观;缺点是 IO 的效率和扩展性很低,容易成为应用性能瓶颈。
- NIO(non-blocking IO) :Java 1.4 引入的 java.nio 包,提供了 Channel、Selector、Buffer 等新的抽象,可以构建多路复用的、同步非阻塞 IO 程序,同时提供了更接近操作系统底层高性能的数据操作方式。
- AIO(Asynchronous IO) :也称 NIO.2,是 Java 1.7 引入的,对 NIO 的扩展,提供了异步非阻塞的 IO 操作方式,所以人们叫它 AIO(Asynchronous IO)。异步 IO 是基于事件和回调机制实现的,也就是应用操作之后会直接返回,不会阻塞在那里,当后台处理完成,操作系统会通知相应的线程进行后续的操作。
# NIO是怎么实现的?
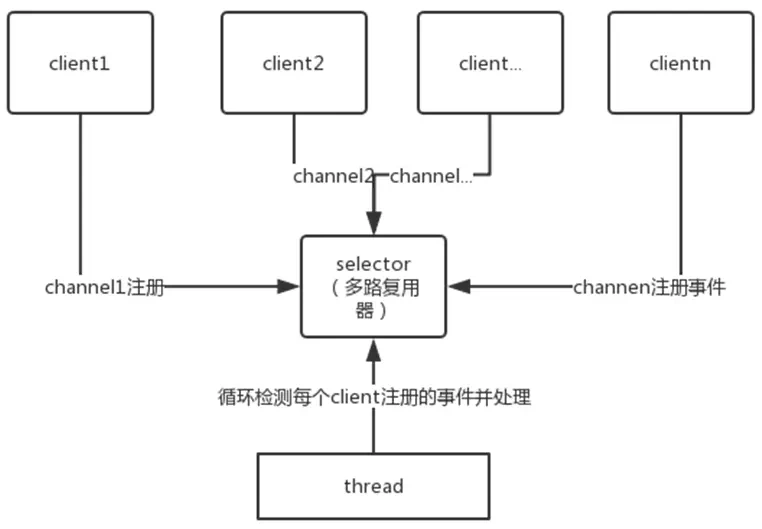
Java NIO主要通过Channel、Buffer、Selector这三个核心组件来实现。在网络编程中,把通道设置为非阻塞模式,再配合Selector,就可以让一个线程管理多个连接。
三个组件的作用分别是:
- Channel(通道):负责数据的读写,比如SocketChannel用于网络连接。通道本身可以工作在阻塞模式,也可以工作在非阻塞模式,使用Selector时需要设置为非阻塞模式。
- Buffer(缓冲区):负责存放数据。从Channel读取的数据会放进Buffer,发送数据时则把Buffer中的数据写入Channel。
- Selector(多路复用器):负责监听多个通道的就绪事件,比如有新的连接到来、通道可读或者可写。
以一个网络服务器为例,基本的处理过程是:
- 把ServerSocketChannel设置为非阻塞模式,注册到Selector,监听连接事件。
- 有客户端连接后,创建对应的SocketChannel,同样设置为非阻塞模式,注册到Selector,监听读事件。
- 线程调用Selector的select方法,等待通道就绪。
- select返回后,遍历就绪事件,对相应的通道执行接收连接、读取数据或者写入数据的操作。
这样,一个连接暂时没有数据时,线程就不用一直等在这个连接上,可以去处理其他已经就绪的连接。
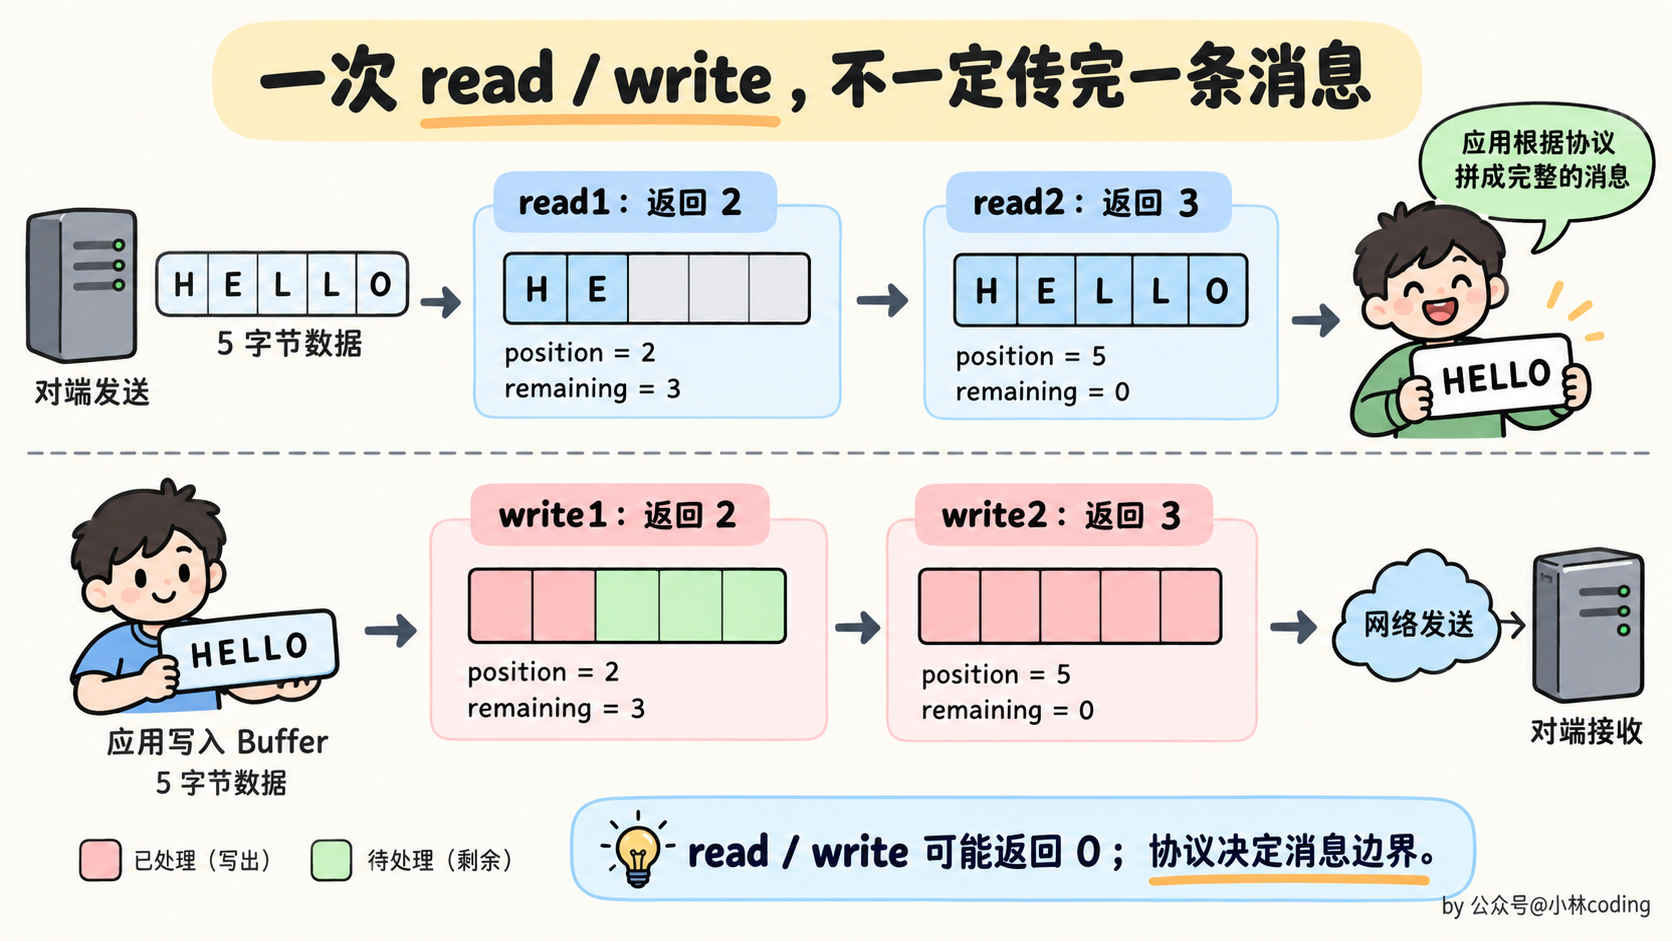
**这里的“非阻塞”,主要指通道的读写操作不会为了等待数据就绪而一直阻塞。**比如非阻塞的SocketChannel调用read时,没有数据可读,就可能返回0。但Selector的select()本身可以阻塞等待事件,selectNow()才是立即返回。
**而“同步”,是指通道就绪后,仍然需要应用线程自己调用read、write完成数据读写。**Selector通知的是“可以读写了”,不会替应用把数据读好。
还要注意,通道就绪不代表一次就能读完或写完所有数据。一次read可能只读到一部分数据,一次write也可能只写出一部分数据,所以程序需要保留未处理的数据,后续继续处理。Buffer只是存放数据的容器,不能保证一次IO操作就完成。
NIO提高并发能力的关键,就是让少量线程管理大量连接,减少一个连接对应一个线程带来的资源开销。如果业务处理比较耗时,一般还会把业务任务交给其他线程处理,避免占住负责IO事件的线程。
# 你知道有哪个框架用到NIO了吗?
**Netty就是一个典型的例子。**它在Java NIO之上封装了网络通信能力,我们不用自己写Selector循环、维护连接状态,就能实现网络服务。
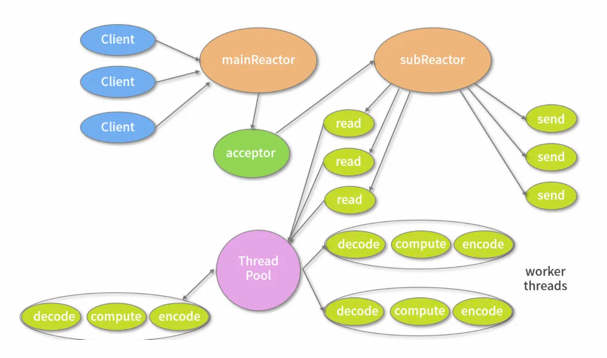
使用NIO传输时,Netty主要通过NioEventLoopGroup、NioEventLoop和Channel来组织IO处理:
- EventLoopGroup:管理一组EventLoop,负责分配连接。
- EventLoop:在NIO实现中,通常由一个线程运行事件循环,通过Selector监听多个Channel的就绪事件,再处理读写和其他任务。
- ChannelPipeline和ChannelHandler:负责把网络事件交给相应的处理逻辑,比如解码、业务处理、编码等。
以TCP服务器为例,常见的配置是两组EventLoopGroup:bossGroup处理接收连接,workerGroup处理连接上的读写事件。一个worker中的EventLoop可以管理多个连接,所以不需要给每个连接都创建一个线程。
这里要区分一下,Netty的NIO传输和原生epoll传输是两种实现:
- 使用NioEventLoopGroup时,依赖Java NIO的Selector;Selector底层采用什么机制,由JDK和操作系统的实现决定。
- 在Linux上使用EpollEventLoopGroup时,走的是Netty的原生epoll传输,不再通过Java的Selector API,需要对应的原生依赖。
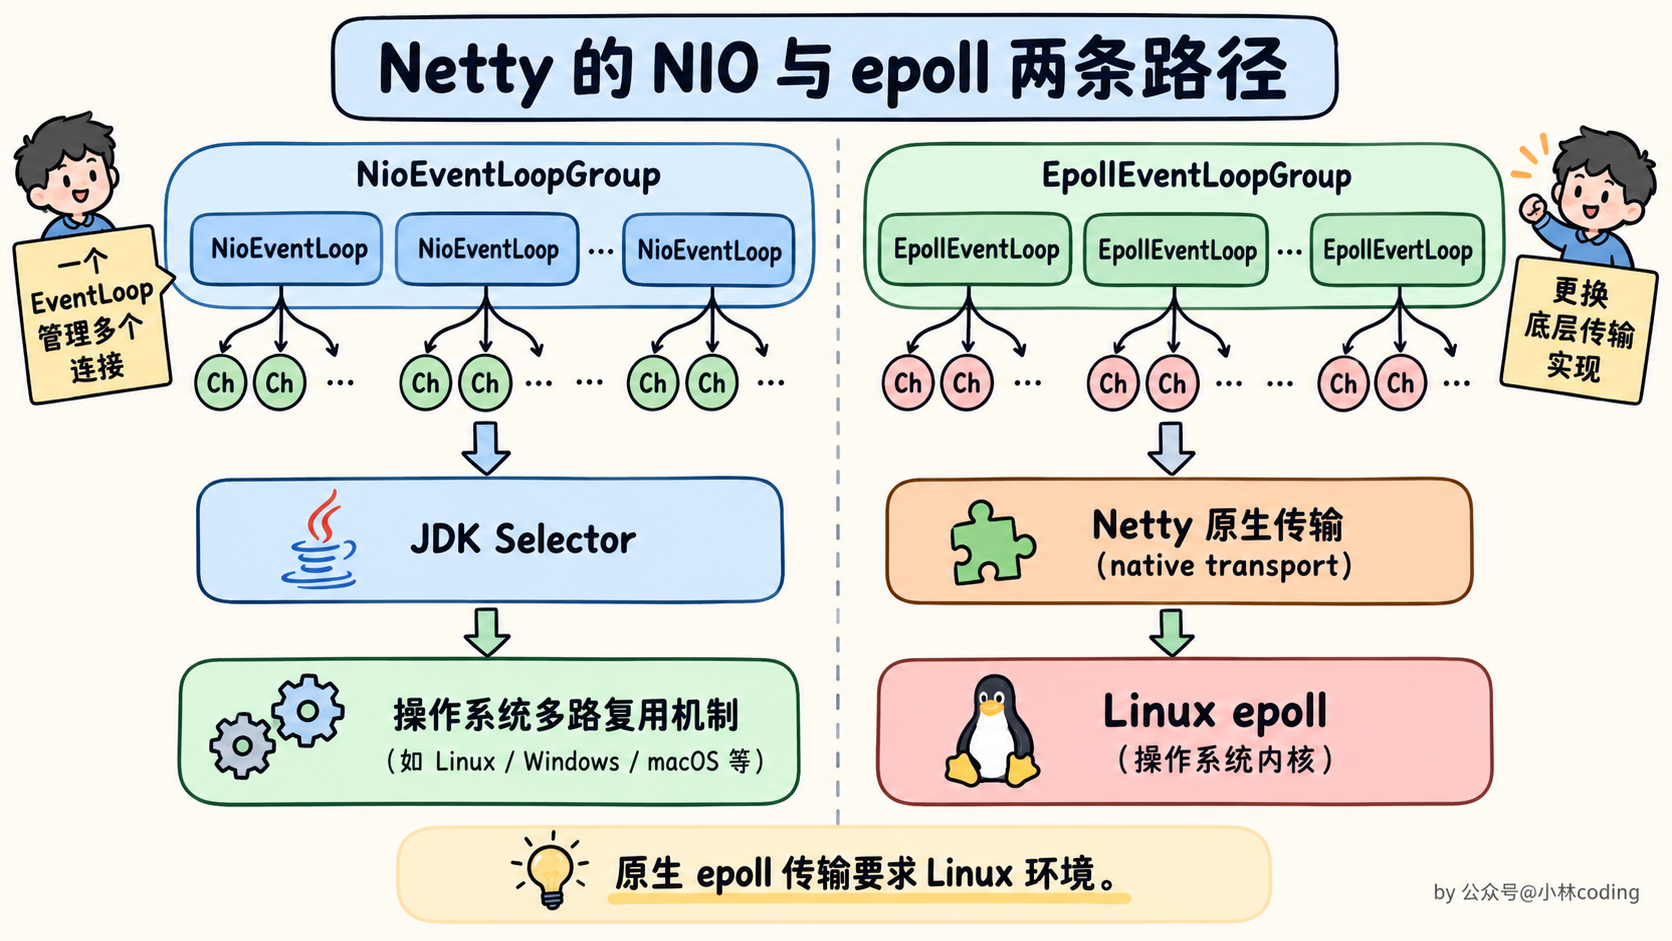
所以,不能简单理解成“Netty使用epoll后,整个服务就只有一个线程”。线程数量取决于EventLoopGroup的配置,一个EventLoop管理多个Channel,多个EventLoop可以一起工作。
从事件模型上说,这两类实现主要采用Reactor模式:监听IO就绪事件,再由应用线程执行读写。Netty API中的异步操作和Future,也不代表底层就一定采用Proactor模型。
实际开发中还要注意,不要在EventLoop里直接执行耗时的数据库查询、阻塞RPC调用等任务,否则会影响同一个EventLoop管理的其他连接。可以把这些任务交给业务线程池,再把结果交回后续处理流程。
# 其他
# 有一个学生类,想按照分数排序,再按学号排序,应该怎么做?
可以使用Comparable接口来实现按照分数排序,再按照学号排序。首先在学生类中实现Comparable接口,并重写compareTo方法,然后在compareTo方法中实现按照分数排序和按照学号排序的逻辑。
public class Student implements Comparable<Student> {
    private int id;
    private int score;

    // 构造方法和其他属性、方法省略

    @Override
    public int compareTo(Student other) {
        if (this.score != other.score) {
            return Integer.compare(other.score, this.score); // 按照分数降序排序
        } else {
            return Integer.compare(this.id, other.id); // 如果分数相同,则按照学号升序排序
        }
    }
}
然后在需要对学生列表进行排序的地方,使用Collections.sort()方法对学生列表进行排序即可:
List<Student> students = new ArrayList<>();
// 添加学生对象到列表中
Collections.sort(students);
# Native方法解释一下
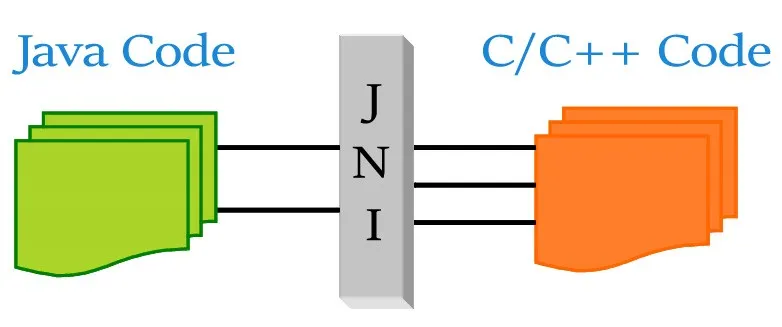
在Java中,native方法是一种特殊类型的方法,它允许Java代码调用外部的本地代码,即用C、C++或其他语言编写的代码。native关键字是Java语言中的一种声明,用于标记一个方法的实现将在外部定义。
在Java类中,native方法看起来与其他方法相似,只是其方法体由native关键字代替,没有实际的实现代码。例如:
public class NativeExample {
    public native void nativeMethod();
}
要实现native方法,你需要完成以下步骤:
- 生成 JNI 头文件:使用
javac -h <dir>选项从你的 Java 类生成 C/C++ 的头文件,这个头文件包含了所有 native 方法的原型(注意:旧的独立工具javah自 Java 9 起被废弃,Java 10 已正式移除,应改用javac -h)。 - 编写本地代码:使用C/C++编写本地方法的实现,并确保方法签名与生成的头文件中的原型匹配。
- 编译本地代码:将C/C++代码编译成动态链接库(DLL,在Windows上),共享库(SO,在Linux上)
- 加载本地库:在Java程序中,使用System.loadLibrary()方法来加载你编译好的本地库,这样JVM就能找到并调用native方法的实现了。
# Java 进程是怎么跟操作系统交互的?
Java程序虽然是运行在JVM上的,但JVM本身就是一个操作系统进程,所以Java跟操作系统的交互,本质上是通过JVM这个中间层来完成的。
最基础的交互就是内存管理。JVM启动时会通过系统调用向操作系统申请内存,比如在Linux上用mmap、brk这些系统调用来分配堆内存、栈内存。虽然我们在Java代码里写new对象,但底层还是要跟操作系统打交道获取真实的物理内存。
线程管理也是重要的交互点。Java 中传统的平台线程(platform thread)与操作系统的原生线程是一对一的关系,在 Linux 上会调用 pthread_create 来创建线程;线程的调度、同步机制(比如 synchronized 底层用的互斥锁)最终都是由操作系统来管理的。注意:Java 21 引入的虚拟线程(virtual thread)属于用户态,不直接对应 OS 线程,而是由 JVM 调度并复用到少量平台载体线程上执行。
IO操作是最频繁的交互场景。文件读写会调用read、write这些系统调用,网络编程底层也是调用socket、bind、listen这些系统调用。Java的NIO用的是操作系统提供的高性能IO机制,Linux上是epoll,Windows上是IOCP。
JNI是另一个重要通道。有些操作Java做不了或者性能不够,就通过JNI调用C/C++代码,这些本地代码可以直接调用操作系统API。JVM本身也大量使用JNI来实现底层功能。
还有信号处理,比如你用kill命令给Java进程发SIGTERM信号,JVM会捕获这个信号然后执行关闭钩子。进程间通信、获取系统资源信息这些,底层也都是通过系统调用完成的。
从用户态和内核态的角度说,Java代码运行在用户态,但IO、网络这些操作需要切换到内核态,这个切换是有开销的。JVM会做很多优化,比如用缓冲区减少系统调用次数。虽然JVM屏蔽了底层差异让Java代码跨平台,但在每个平台上JVM都要适配该平台的系统调用和API。
最新的图解文章都在公众号首发,别忘记关注哦!!如果你想加入百人技术交流群,扫码下方二维码回复「加群」。